分身して戦い、負けて消えた分身の記憶を本体が受け取り強くなる。アニメや漫画ではおなじみの展開である。AIで同じことをやってみた[1]。
前の記事では、マトリョーシカ構造のGemma 3nで、小さいモデルが作った記憶を大きいモデルへ移植し一定の効果が確認できた。今回は複数の小さいモデルが分担して作った記憶を、一つにまとめて大きいモデルで使えるか実験した[2]。結果、記憶を統合することも一定できそうで、うまく統合すると8割正解できる。一方で統合せずに二つの表を正しく使い分けた場合(属性約89%、消費魔力約82%)には届かなかった。
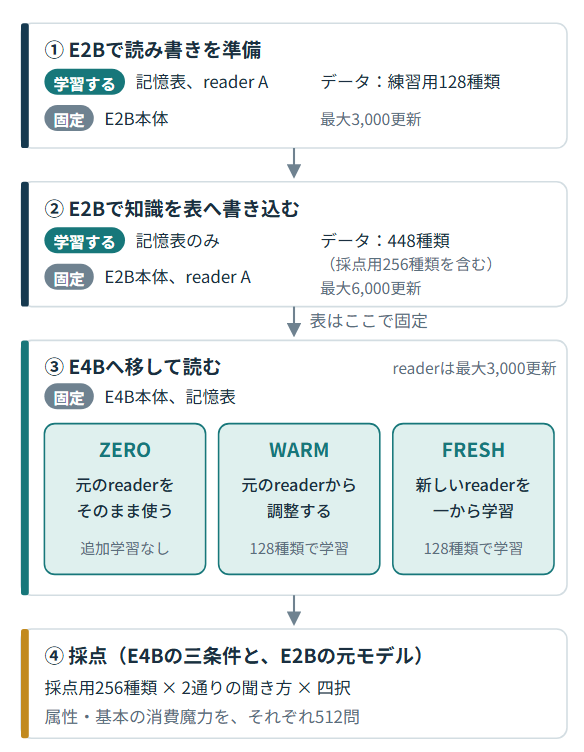
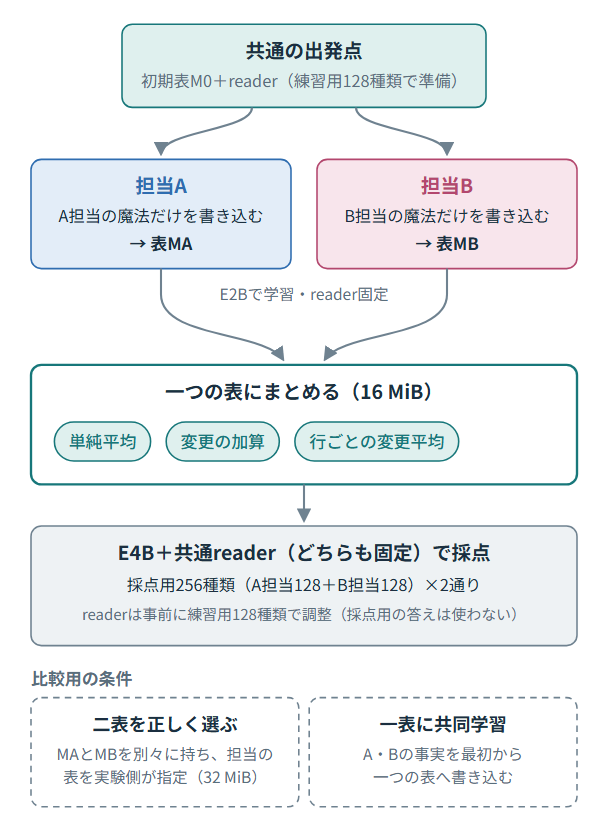
今回の実験では追加したEngram型の記憶領域・表だけを別々に学習してマージしている。実験の流れは下図の通り。表のマージ方針で差異が出ているのが興味深い[3]。
モデルに記憶させるもの
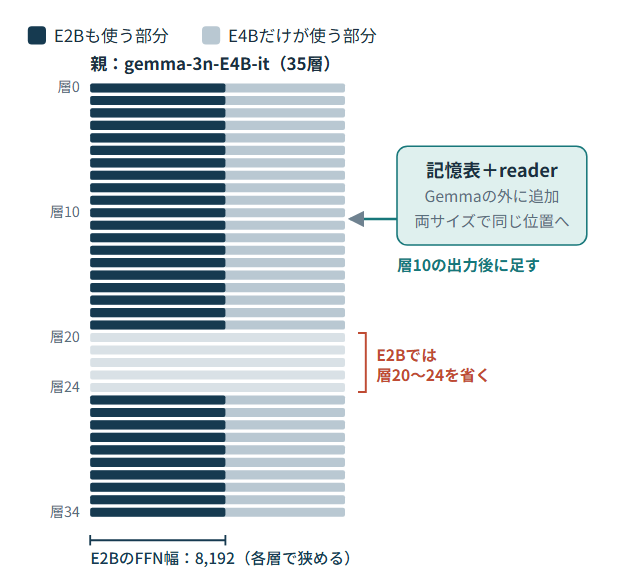
基本的な構成は前回同様である。記憶する魔導書は「ルドラの秘宝」の言霊から着想を得た実験用のものである。三文字の魔法名を根底語とし、「火・水・風・土」の属性と、1から4までの基本の消費魔力を割り当てている。小モデルはGemma 3nのE2B構成、大モデルはE4Bと前回同様である。同じ親から大小を作り、どちらも本体のweightを凍結している。読み方の練習用128種類は共通、途中確認用と採点用をAとBで半分ずつ分担した。
※ 採点用の知識は分担、AとBで異なるが練習用データには重複がある。
| データ | Aの担当 | Bの担当 |
|---|---|---|
| 読み方の練習用 | 共通の128種類 | Aと同じ128種類 |
| 途中確認用 | 32種類 | Aとは別の32種類 |
| 採点用 | 128種類 | Aとは別の128種類 |
| 書き込む種類の合計 | 288種類 | 288種類 |
手法
記憶の移植先であるE4Bでは、共通初期状態のreaderを基に、練習用128種類とA/Bの表で読み方を調整した。その後はreaderを固定し、表だけを差し替えて評価する。採点用256種類の答えは、readerの学習には使っていない。
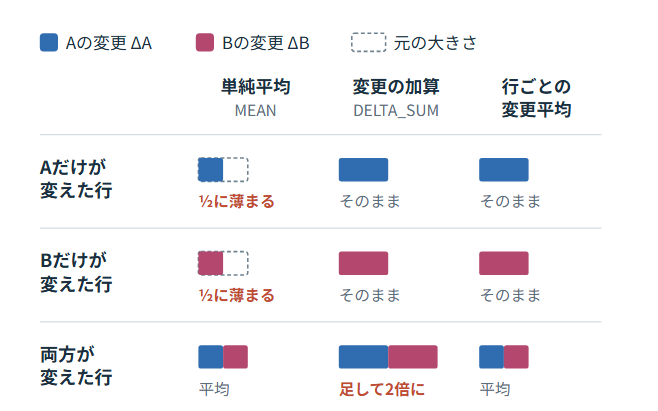
共通の初期表をM0、AとBが作った表をMA、MBとする。M0からの変更分を、それぞれΔA=MA−M0、ΔB=MB−M0として下記の3パターンを試した。「M0+α × (ΔA+ΔB)」を考えると、単純平均はα=1/2、変更の加算はα=1、行ごとの変更平均は「その行を変えた担当の数」で割ったものである。
| 方法 | 実施すること |
|---|---|
| 単純平均 | MAとMBの値を平均する |
| 変更の加算 | 初期表M0に、Aの変更ΔAとBの変更ΔBを両方足す |
| 行ごとの変更平均 | 片方だけが変えた行はその変更を残し、両方が変えた行では変更を平均する |
比較として下記パターンも検証している。
| 方法 | 実施すること |
|---|---|
| 二表を正しく選ぶ | A/Bの表を別々に持ち、問題の魔法を担当した方の表を実験側で指定 |
| 一表に共同学習 | A/Bの事実を最初から一つの表へ書く |
今回もGoogle Colab上のRTX PRO 6000 Blackwell Server Edition 1枚で実験を行っている。比較対照・統合後の評価まで含めて約6時間かかった。
結果
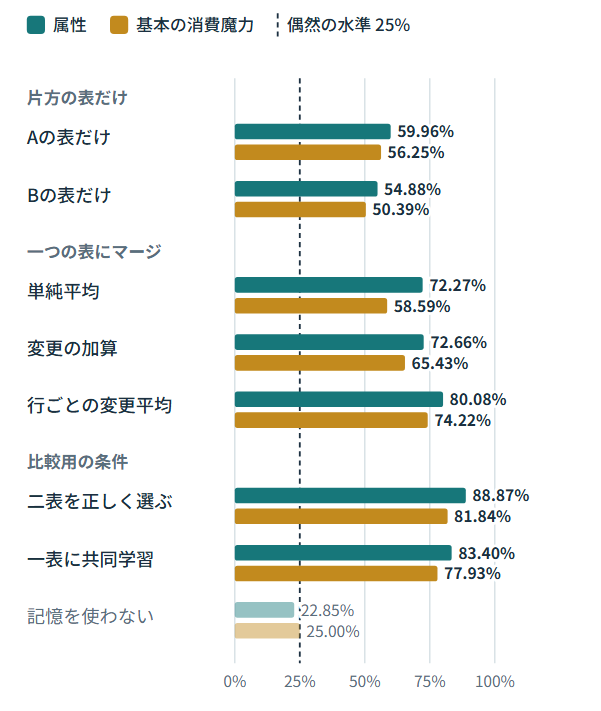
結果は下図の通りで、表のマージは一定可能そうに見える。
1. 小さいモデルの複数の記憶を大きなモデルで使えるか? → 属性も消費魔力も使える
| 渡した記憶・情報 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| Aの表だけ | 59.96% | 56.25% |
| Bの表だけ | 54.88% | 50.39% |
| 二表を正しく選ぶ | 88.87% | 81.84% |
| 一表に共同学習 | 83.40% | 77.93% |
| 記憶を使わない | 22.85% | 25.00% |
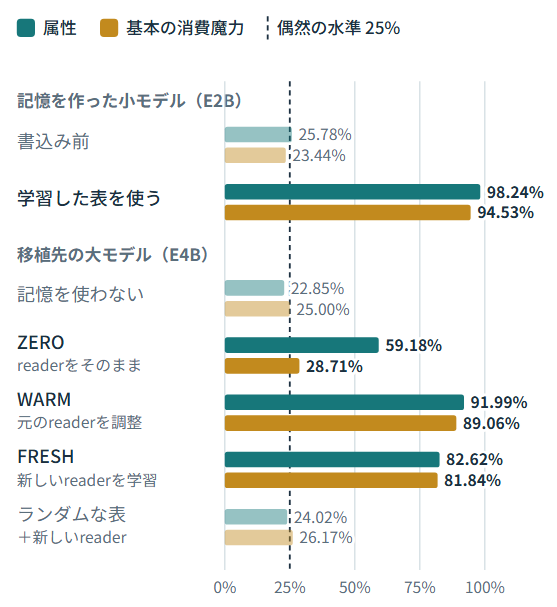
AかBの表だけでは属性・消費魔力とも正解率は6割弱だが、正しい担当の表を使うと属性88.87%、消費魔力81.84%となる。大モデルが、分担して作った両方の記憶を利用できている。
属性88.87%、消費魔力81.84%というスコアは正しい表を実験側で与えた結果であることに注意が必要なものの、一表に共同学習している結果を上回るのは意外である[4]。
2. 一つの記憶領域・表にマージしても使えるか? → 使えるが、方法によって差がある
| マージ方法 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| 単純平均 | 72.27% | 58.59% |
| 変更の加算 | 72.66% | 65.43% |
| 行ごとの変更平均 | 80.08% | 74.22% |
| 参考:二表を正しく選ぶ | 88.87% | 81.84% |
3パターンのマージ方式では、行ごとの変更平均のスコアが高かった。ただし、二表を正しく選ぶ場合からは、属性で8.79ポイント、消費魔力で7.62ポイント低く完璧に統合できてはいない。
3. 片方の記憶だけを使っていないか? → 両方の記憶が使える
結果を、担当する魔法ごとに分けると下記のようになる。片方の表だけでは、担当外の正答率はランダムと同じ25%前後になる。分担した魔導書を集約する狙いに沿った結果になった。
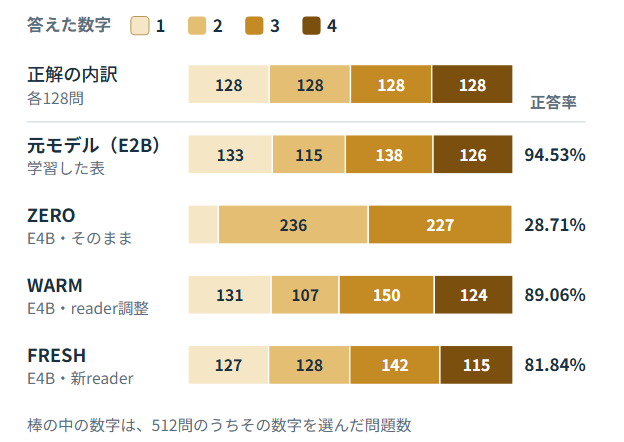
一方、消費魔力では担当による違いが目立つ。Aの表はA担当の消費魔力を92.58%正解するが、行ごとの変更平均では75.00%まで下がった。B担当は、もともとBの表で71.09%で、統合後も73.44%とほぼ変わらない。前回同様、属性と魔力で動作が異なっているのが興味深い。
| 条件 | A担当・属性 | B担当・属性 | A担当・消費魔力 | B担当・消費魔力 |
|---|---|---|---|---|
| Aの表だけ | 92.19% | 27.73% | 92.58% | 19.92% |
| Bの表だけ | 24.22% | 85.55% | 29.69% | 71.09% |
| 二表を正しく選ぶ | 92.19% | 85.55% | 92.58% | 71.09% |
| 単純平均 | 76.95% | 67.58% | 59.77% | 57.42% |
| 変更の加算 | 76.17% | 69.14% | 68.75% | 62.11% |
| 行ごとの変更平均 | 82.42% | 77.73% | 75.00% | 73.44% |
4. 統合でどれくらいの記憶を失ったか? → 変化した回答は多く、自信を持って間違える
行ごとの変更平均は、属性で二表を正しく選ぶ場合より8.79ポイント低い。正解数は455問から410問へ減少している。問題別に分析すると下記のようになる。
| 二表選択から一表統合への変化 | 属性の問題数 |
|---|---|
| 正解 → 正解 | 399 |
| 正解 → 不正解 | 56 |
| 不正解 → 正解 | 11 |
| 不正解 → 不正解 | 46 |
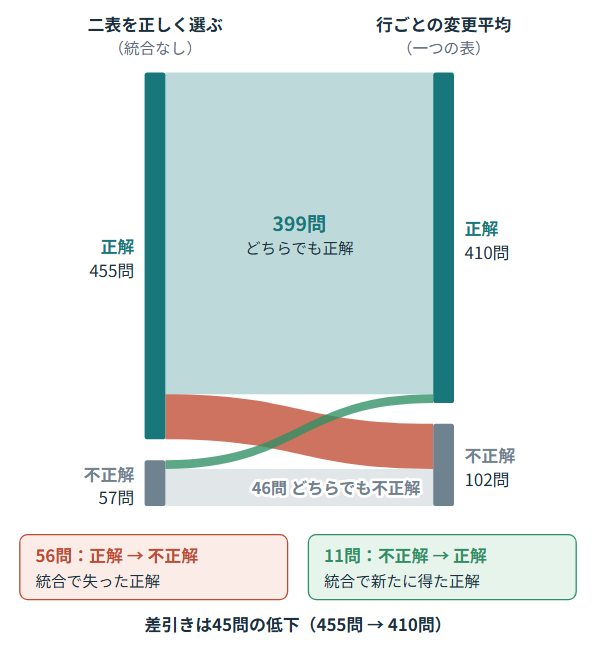
行ごとの変更平均で消費魔力を間違えた132問のうち、105問では、誤った答えに9割以上の確率を付けていた。統合で失われた知識について「自信がない」とはならず、自信を持って間違えている。これは前回も見られた傾向である。
記憶の仕方に関する分析
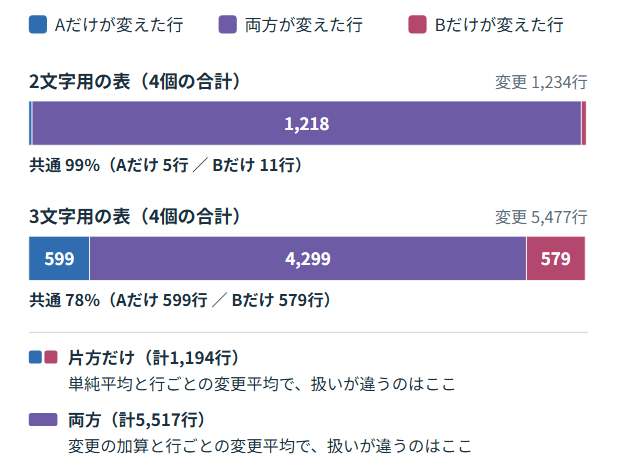
今回の記憶では質問文の2〜3文字の並びから複数の行を参照するアーキテクチャを用いており、違う魔法でも同じ場所を使うことがある。AとBが変えた領域は下図のようになった。どちらかが変えた部分を丁寧に扱うのに効果があるのはそうだと思いつつ、練習用の128種類が影響しているのか、衝突している領域が意外と多かった。
所感
「分身が別々に覚えた記憶を本体へ集める」という展開を小さな規模で試行、それっぽい結果にはなった[5]。
前回を含めてだが、Aの魔法とBの魔法の消費魔力を足す、といった問題は実施しておらず、記憶を組み合わせた推論や計算などより高度な処理に使えるのか?という疑問はある。このあたりはぜひ検証してみたいところである。
改めてEngramはモデルに組み込みやすく効果が出やすい面白い手法だと思う。外部メモリ関連はなかなか実用に足るものが出てきていなかったが、今後このあたりの研究が進むと良いなと思う。
最近の検証はGPT-6 AstraをChatGPTとCodexから使って実施、同じ環境+Claude(Opus 5.5)で分析などを行っている。アイデアから実験、分析までとても素早くできる時代になって改めて技術の進化を感じる。
脚注
[1] 先行研究は多くある。Peng Wang et al. “WISE: Rethinking the Knowledge Memory for Lifelong Model Editing of Large Language Models.” Advances in Neural Information Processing Systems, 37, 2024.(https://arxiv.org/abs/2405.14768)、Ryan Wei Heng Quek, et al., “MeMo: Memory as a Model,” 2026.(https://arxiv.org/abs/2605.15156)など。いずれも複数の記憶(編集差分や記憶モデル)の統合を扱うが、WISEはFFN部分を利用、MeMoは記憶モデルへの問い合わせであり、今回のEngram型記憶表の統合とは、記憶の形式と読み出し方が異なる。
[2] 実験設定は前回とほぼ同じである。Google, “Gemma 3n model overview,” に Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. (https://arxiv.org/abs/2601.07372)のEngramを参考にした記憶領域を組み込み、Mingyuan Li, et al, “Frozen Memory Is Not Enough: Rethinking External Memory as Extraction,” 2026.(https://arxiv.org/abs/2608.17050)と近い手法で記憶領域の移植を試している。
[3] 単純平均でもそこそこのスコアが出せている点は面白いが、モデルマージでも近しい動きがあったりするのでそういうものなんだろうと思わなくはない。また、前回同様、属性よりも魔力の方がスコアが低いのは深堀ポイントな気はしている。
[4] 記憶領域が足りていないのかなという気もしないではない。
[5] そもそもログなり軌跡(trajectory)なりを集めて学習したほうが効果が高く、Memoryだけ抜き出す意味はないのでは?というツッコミはしてはいけない。もちろん、通信量の削減や連合学習的な良さなどあるにはあるが。。。