複数の小規模AIが覚えた記憶(Engram)を、大規模AIがまとめて使う

分身して戦い、負けて消えた分身の記憶を本体が受け取り強くなる。アニメや漫画ではおなじみの展開である。AIで同じことをやってみた[1]。

前の記事では、マトリョーシカ構造のGemma 3nで、小さいモデルが作った記憶を大きいモデルへ移植し一定の効果が確認できた。今回は複数の小さいモデルが分担して作った記憶を、一つにまとめて大きいモデルで使えるか実験した[2]。結果、記憶を統合することも一定できそうで、うまく統合すると8割正解できる。一方で統合せずに二つの表を正しく使い分けた場合(属性約89%、消費魔力約82%)には届かなかった。

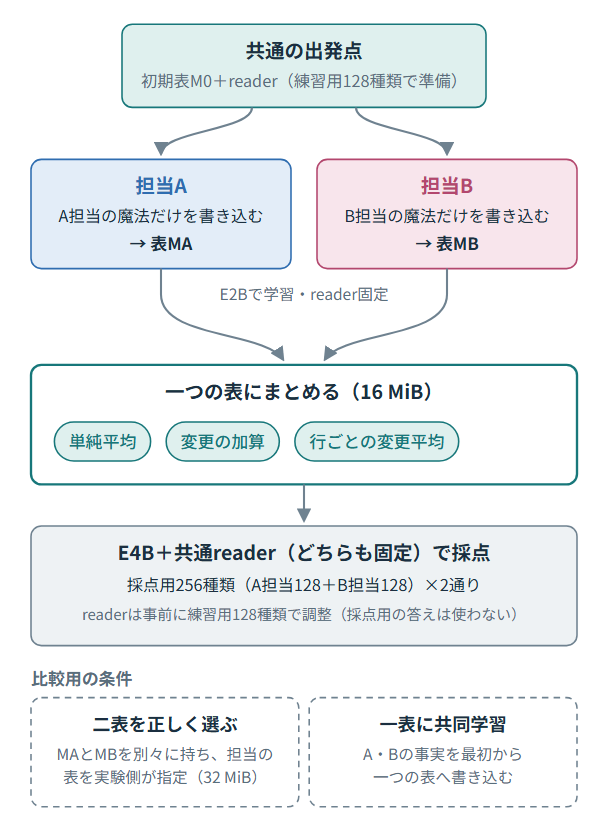
今回の実験では追加したEngram型の記憶領域・表だけを別々に学習してマージしている。実験の流れは下図の通り。表のマージ方針で差異が出ているのが興味深い[3]。
モデルに記憶させるもの

基本的な構成は前回同様である。記憶する魔導書は「ルドラの秘宝」の言霊から着想を得た実験用のものである。三文字の魔法名を根底語とし、「火・水・風・土」の属性と、1から4までの基本の消費魔力を割り当てている。小モデルはGemma 3nのE2B構成、大モデルはE4Bと前回同様である。同じ親から大小を作り、どちらも本体のweightを凍結している。読み方の練習用128種類は共通、途中確認用と採点用をAとBで半分ずつ分担した。
※ 採点用の知識は分担、AとBで異なるが練習用データには重複がある。

データAの担当Bの担当
読み方の練習用共通の128種類Aと同じ128種類
途中確認用32種類Aとは別の32種類
採点用128種類Aとは別の128種類
書き込む種類の合計288種類288種類

手法

記憶の移植先であるE4Bでは、共通初期状態のreaderを基に、練習用128種類とA/Bの表で読み方を調整した。その後はreaderを固定し、表だけを差し替えて評価する。採点用256種類の答えは、readerの学習には使っていない。

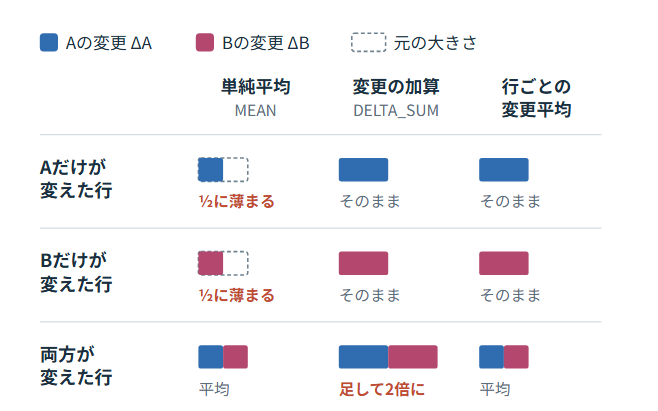
共通の初期表をM0、AとBが作った表をMA、MBとする。M0からの変更分を、それぞれΔA=MA−M0、ΔB=MB−M0として下記の3パターンを試した。「M0+α × (ΔA+ΔB)」を考えると、単純平均はα=1/2、変更の加算はα=1、行ごとの変更平均は「その行を変えた担当の数」で割ったものである。

方法実施すること
単純平均MAとMBの値を平均する
変更の加算初期表M0に、Aの変更ΔAとBの変更ΔBを両方足す
行ごとの変更平均片方だけが変えた行はその変更を残し、両方が変えた行では変更を平均する

比較として下記パターンも検証している。

方法実施すること
二表を正しく選ぶA/Bの表を別々に持ち、問題の魔法を担当した方の表を実験側で指定
一表に共同学習A/Bの事実を最初から一つの表へ書く

今回もGoogle Colab上のRTX PRO 6000 Blackwell Server Edition 1枚で実験を行っている。比較対照・統合後の評価まで含めて約6時間かかった。

結果

結果は下図の通りで、表のマージは一定可能そうに見える。
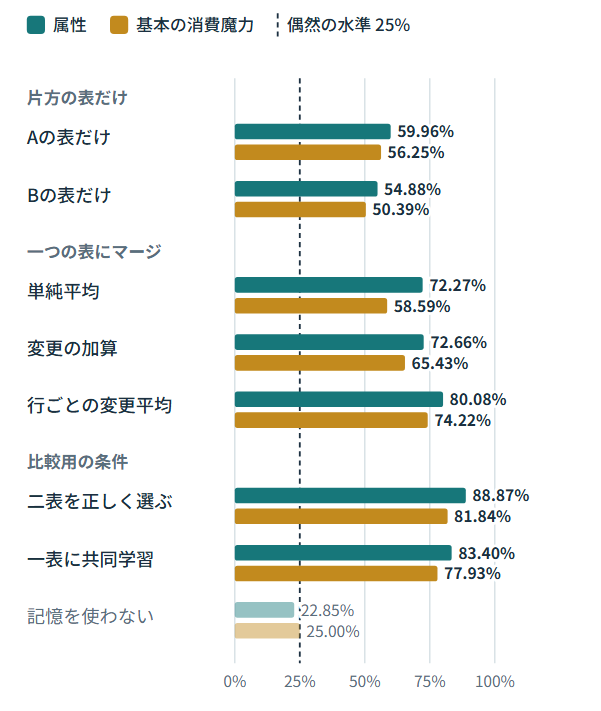
1. 小さいモデルの複数の記憶を大きなモデルで使えるか? → 属性も消費魔力も使える

渡した記憶・情報属性の正答率基本の消費魔力の正答率
Aの表だけ59.96%56.25%
Bの表だけ54.88%50.39%
二表を正しく選ぶ88.87%81.84%
一表に共同学習83.40%77.93%
記憶を使わない22.85%25.00%

AかBの表だけでは属性・消費魔力とも正解率は6割弱だが、正しい担当の表を使うと属性88.87%、消費魔力81.84%となる。大モデルが、分担して作った両方の記憶を利用できている。
属性88.87%、消費魔力81.84%というスコアは正しい表を実験側で与えた結果であることに注意が必要なものの、一表に共同学習している結果を上回るのは意外である[4]。

2. 一つの記憶領域・表にマージしても使えるか? → 使えるが、方法によって差がある

マージ方法属性の正答率基本の消費魔力の正答率
単純平均72.27%58.59%
変更の加算72.66%65.43%
行ごとの変更平均80.08%74.22%
参考:二表を正しく選ぶ88.87%81.84%

3パターンのマージ方式では、行ごとの変更平均のスコアが高かった。ただし、二表を正しく選ぶ場合からは、属性で8.79ポイント、消費魔力で7.62ポイント低く完璧に統合できてはいない。

3. 片方の記憶だけを使っていないか? → 両方の記憶が使える

結果を、担当する魔法ごとに分けると下記のようになる。片方の表だけでは、担当外の正答率はランダムと同じ25%前後になる。分担した魔導書を集約する狙いに沿った結果になった。

一方、消費魔力では担当による違いが目立つ。Aの表はA担当の消費魔力を92.58%正解するが、行ごとの変更平均では75.00%まで下がった。B担当は、もともとBの表で71.09%で、統合後も73.44%とほぼ変わらない。前回同様、属性と魔力で動作が異なっているのが興味深い。

条件A担当・属性B担当・属性A担当・消費魔力B担当・消費魔力
Aの表だけ92.19%27.73%92.58%19.92%
Bの表だけ24.22%85.55%29.69%71.09%
二表を正しく選ぶ92.19%85.55%92.58%71.09%
単純平均76.95%67.58%59.77%57.42%
変更の加算76.17%69.14%68.75%62.11%
行ごとの変更平均82.42%77.73%75.00%73.44%

4. 統合でどれくらいの記憶を失ったか? → 変化した回答は多く、自信を持って間違える

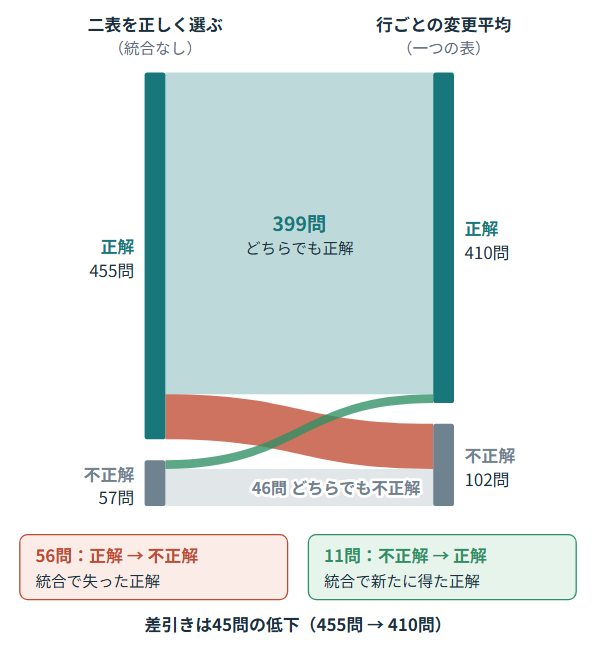
行ごとの変更平均は、属性で二表を正しく選ぶ場合より8.79ポイント低い。正解数は455問から410問へ減少している。問題別に分析すると下記のようになる。

二表選択から一表統合への変化属性の問題数
正解 → 正解399
正解 → 不正解56
不正解 → 正解11
不正解 → 不正解46

行ごとの変更平均で消費魔力を間違えた132問のうち、105問では、誤った答えに9割以上の確率を付けていた。統合で失われた知識について「自信がない」とはならず、自信を持って間違えている。これは前回も見られた傾向である。

記憶の仕方に関する分析

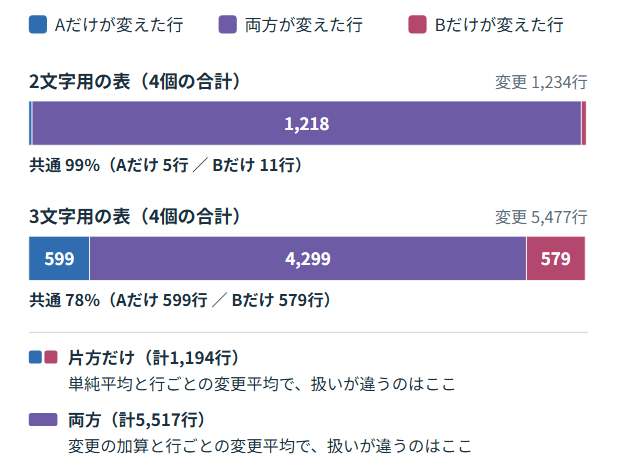
今回の記憶では質問文の2〜3文字の並びから複数の行を参照するアーキテクチャを用いており、違う魔法でも同じ場所を使うことがある。AとBが変えた領域は下図のようになった。どちらかが変えた部分を丁寧に扱うのに効果があるのはそうだと思いつつ、練習用の128種類が影響しているのか、衝突している領域が意外と多かった。
所感

「分身が別々に覚えた記憶を本体へ集める」という展開を小さな規模で試行、それっぽい結果にはなった[5]。

前回を含めてだが、Aの魔法とBの魔法の消費魔力を足す、といった問題は実施しておらず、記憶を組み合わせた推論や計算などより高度な処理に使えるのか?という疑問はある。このあたりはぜひ検証してみたいところである。

改めてEngramはモデルに組み込みやすく効果が出やすい面白い手法だと思う。外部メモリ関連はなかなか実用に足るものが出てきていなかったが、今後このあたりの研究が進むと良いなと思う。

最近の検証はGPT-6 AstraをChatGPTとCodexから使って実施、同じ環境+Claude(Opus 5.5)で分析などを行っている。アイデアから実験、分析までとても素早くできる時代になって改めて技術の進化を感じる。

脚注

[1] 先行研究は多くある。Peng Wang et al. “WISE: Rethinking the Knowledge Memory for Lifelong Model Editing of Large Language Models.” Advances in Neural Information Processing Systems, 37, 2024.(https://arxiv.org/abs/2405.14768)、Ryan Wei Heng Quek, et al., “MeMo: Memory as a Model,” 2026.(https://arxiv.org/abs/2605.15156)など。いずれも複数の記憶(編集差分や記憶モデル)の統合を扱うが、WISEはFFN部分を利用、MeMoは記憶モデルへの問い合わせであり、今回のEngram型記憶表の統合とは、記憶の形式と読み出し方が異なる。
[2] 実験設定は前回とほぼ同じである。Google, “Gemma 3n model overview,” に Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. (https://arxiv.org/abs/2601.07372)のEngramを参考にした記憶領域を組み込み、Mingyuan Li, et al, “Frozen Memory Is Not Enough: Rethinking External Memory as Extraction,” 2026.(https://arxiv.org/abs/2608.17050)と近い手法で記憶領域の移植を試している。
[3] 単純平均でもそこそこのスコアが出せている点は面白いが、モデルマージでも近しい動きがあったりするのでそういうものなんだろうと思わなくはない。また、前回同様、属性よりも魔力の方がスコアが低いのは深堀ポイントな気はしている。
[4] 記憶領域が足りていないのかなという気もしないではない。
[5] そもそもログなり軌跡(trajectory)なりを集めて学習したほうが効果が高く、Memoryだけ抜き出す意味はないのでは?というツッコミはしてはいけない。もちろん、通信量の削減や連合学習的な良さなどあるにはあるが。。。
Matryoshka構造のGemma3n + Engramだと記憶は移植しやすい(?)

前の記事では、Qwen3.5 2Bに架空の魔導書を記憶させ、その記憶をQwen3.5 4Bで使えるか試した。結果、一部は使えていそうだが、移植元と移植先で大きな性能差があった。今回は大小のモデルが重みを共有していたら記憶の移植がしやすいのでは?という仮説に基づき、マトリョーシカ構造[1]のGemma 3n [2]を用いて前回同様の実験[3]を行った。

結果、移植元のモデルは属性98.24%、基本の消費魔力94.53%を正解、移植後のモデルで読み方を調整すると91.99%、89.06%正解した。移植元と移植先で差異はあるものの前回より大きく改善している。なお、読み方を調整せずそのまま接続すると59.18%、28.71%で課題が残った[4]。

ベースモデルの構造・マトリョーシカ構造

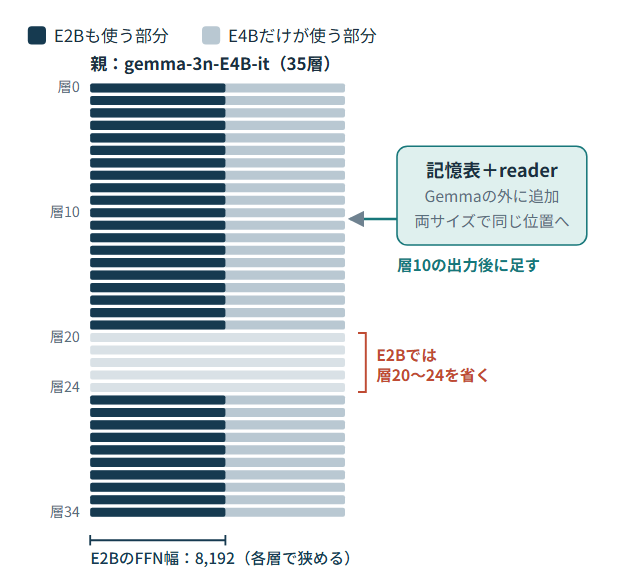
マトリョーシカ構造は大きなモデルの中に小さなモデルが内包され、マトリョーシカ人形のような構造をしている。Gemma 3nはMatFormer[5]を利用しており、大きいE4Bの中に、小さいE2Bのパラメータを含んでいる。今回はgoogle/gemma-3n-E4B-itを親として、E2B構成を切り出して使った(下図参照)。このようなアーキテクチャを用いることでE2B→E4Bの知識移植が効率的に行えないかを検証する。

モデルに記憶させるもの

基本的な構成は前回同様である。記憶する魔導書は「ルドラの秘宝」の言霊から着想を得た実験用のものである。三文字の魔法名を根底語とし、「火・水・風・土」の属性と、1から4までの基本の消費魔力を割り当てている。全512種類を、練習用128種類、途中確認用64種類、採点用256種類、(未登録64種類)に分けた。今回は基本情報を直接尋ねる問題に絞っている。前回と異なり魔導書の差し替えや英語での質問は評価していない。

手法

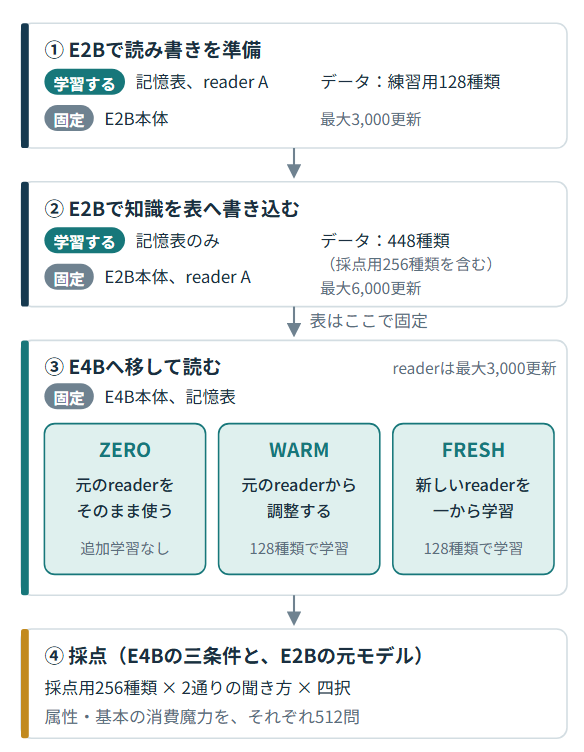
モデル本体の重みは凍結し、追加した記憶領域・表とreaderだけを学習する。今回の表は約4.2Mパラメータ、readerは約0.33Mパラメータである。学習は前回と同じく三段階に分けた。

段階学習するもの固定するもの使うデータ
① E2Bモデルで読み書きを準備記憶領域・表、reader AE2B本体練習用128種類
② 知識を記憶領域へ書き込む記憶領域・表のみE2B本体、reader A448種類。採点用256種類も含む
③ E4Bモデルで読み方を調整readerのみE4B本体、記憶領域・表練習用128種類のみ

②ではreaderを固定し採点用の答えを表以外に覚えさせていない。採点用の情報は元の表のみに影響させ、記憶を介して使えるかを検証する。③も次の3通りに分けている。

条件移植先のreaderをどうするか
ZERO:そのまま移す元のreaderを固定して使う。移植先での追加学習なし
WARM:元の読み方を調整する元のreaderから始め、練習用128種類で追加学習
FRESH:新しく読み方を学ぶreaderを新しく作り、同じ128種類で学習

採点では四つの回答候補の尤度を比べ、最も高い候補を予測とする。属性は0=火、1=水、2=風、3=土、消費魔力は1〜4を候補とした。採点用256種類に2通りの聞き方を使うため、各列の分母は512問である。正解は各候補128問ずつなので、ランダムに答えても、同じ候補を答え続けても、期待正答率は25%になる。

実験はColab上のNVIDIA RTX PRO 6000 Blackwell Server Editionで行った。本体はBF16、表とreaderはFP32である。学習時には8例分をためてパラメータを更新した。early stoppingを有効にし全体の計算時間は約12時間である。

結果

結果概要は下記の通りである。Gemma 3n + engramは有効そうである。記憶の移植も前回より良い性能でできている。ただ、マトリョーシカ構造であってもreaderもそのまま移植するのは難しそうに見える。

1. LLM+Engramで記憶できるか? → 属性も消費魔力も9割以上

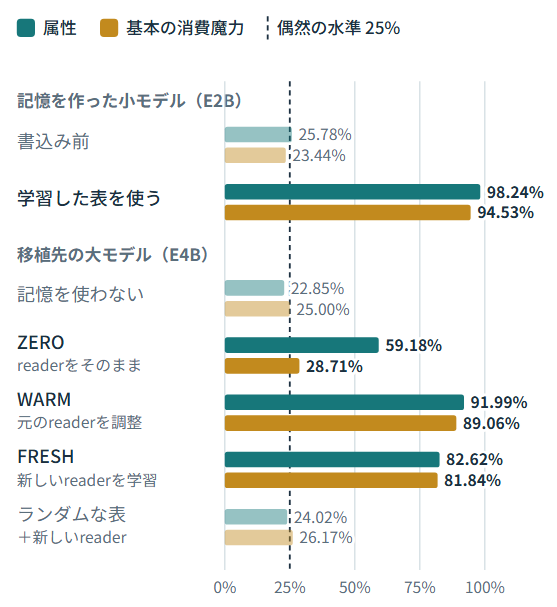
元モデル(E2B)の状態属性の正答率基本の消費魔力の正答率
採点用の事実を書き込む前25.78%23.44%
書込み後、学習した表を使う98.24%94.53%
書込み後、記憶を使わない27.73%24.02%

事実を書き込む前や、記憶を使わない場合はほぼランダムな結果である。学習した表を使うと、属性・消費魔力とも9割超と、記憶を作ったE2Bモデルは記憶を有効に使えていそうである。

2. 記憶と読み方をそのまま移せるか? → 属性のみ一部移せた。調整すれば両方有効になる。

移植先(E4B)の条件属性の正答率基本の消費魔力の正答率
記憶を使わない22.85%25.00%
そのまま接続:ZERO59.18%28.71%
元のreaderを調整:WARM91.99%89.06%
新しいreaderを学習:FRESH82.62%81.84%
ランダムな表+新しいreader24.02%26.17%
並べ替えた表+新しいreader24.80%26.37%

ZERO(記憶表も記憶を読み取る部品であるreaderもそのまま移植)は属性59.18%で、記憶なしの22.85%を上回る。一方、消費魔力は28.71%とランダムに近い。マトリョーシカ構造の大小モデルであってもreaderの調整なしに記憶が使えるわけではなさそうである。

WARM、FRESHというreaderを調整する条件ではE2Bで記憶した内容を有効に使えていることが分かる。ただし、元の性能を完全に保てているわけではない。

3. スコアが落ちた理由は?

スコアが落ちた原因を調べるため追加的な検証を行った。まず、E2Bモデルを用いて、readerだけを新しくし練習用128種類で学習し直すと正解率は属性77.15%、消費魔力72.46%だった。記憶の利用においてはreaderの果たす役割が大きいことが分かる。また、FRESHでの比較、E2B(77.15%、72.46%)とE4B(82.62%、81.84%)の差は128例でreaderを学ぶことの限界を示唆しているように思う。

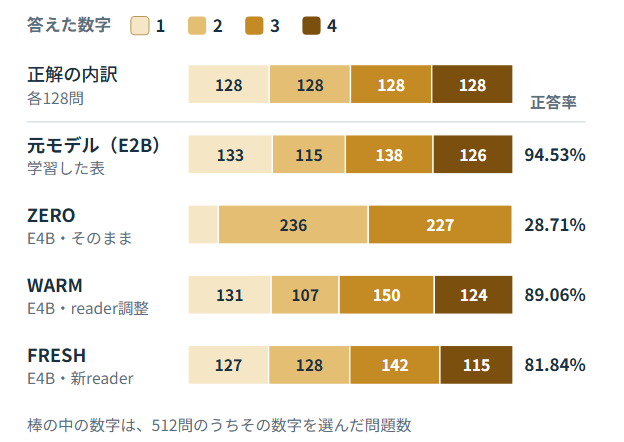
次にZEROで正解率の低かった消費魔力についてモデル出力を検証した。すると、そのまま接続したZEROだけは、512問中236問で「2」、227問で「3」を選ぶなど回答に大きな偏りが出ていた。さらに、間違えた365問のうち255問では、選んだ誤答に9割以上の確率を付けるなど謎の挙動をしている。前回の結果でも示唆されていたが、属性と魔力値でモデル内の扱いが異なっていそうに見える。例えば、消費魔力が数値として扱われ順序ある軸上に表現されたと仮定すると、中間値の「2」「3」によるのは一定理解できる。実際そうなっているかはっきりしないことに注意が必要だが、とても興味深い。

所感

Engram型の記憶を、マトリョーシカ構造のGemma 3nで移植してみた。共通の親から作った大小モデルでも、そのまま記憶を移植することは難しかった。属性の一部は使えたが、消費魔力はほぼ読めなかった。一方で別の魔法の情報を使い、読み方を少し練習するだけでスコアが大きく上がった。前回のQwen3.5との比較だけでは何とも言えないが、他のモデルも幅広く試すとマトリョーシカ構造の効果なのか、単にモデル性能の差なのかなどがはっきりしそうである。

また、前回の結果でも示唆されていたが、属性と魔力値の学習経過が異なるように見える[6]。モデル中で数値(順序関係のあるもの、あるいは、加算など数学的扱いが可能な形式言語)と自然言語の扱いが異なるとかだと非常に面白いと思う。うまく実験設計して差を見てみたい。

この実験で小モデルの記憶を大モデルに移植することはいったん見込みが立った[7]。次は、小モデルが分担して覚えた記憶を一つにまとめ、大モデルで使えるかを試してみた。分身が持ち帰った敵の情報を本体が学習する、ありがちだが熱い展開である。

脚注

[1] LLM構築ではなくembeddingを対象とした論文だが考え方はAditya Kusupati, et al, “Matryoshka Representation Learning,” 2024.(https://arxiv.org/abs/2205.13147)が早期に出ている。
[2] Google, “Gemma 3n model overview,” 「Model parameters and effective parameters」「MatFormer architecture」節、およびGoogleのGemma 3n E4B-itモデルカード。
[3]  Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. (https://arxiv.org/abs/2601.07372)のEngramを参考に記憶領域をGemma3nに組み込み、Mingyuan Li, et al, “Frozen Memory Is Not Enough: Rethinking External Memory as Extraction,” 2026.(https://arxiv.org/abs/2608.17050)と同様、記憶領域の移植を試している。
※前回の記事時点からバージョンアップがあり、2608.17050の題名が変わっていた。
[4] 微妙な結果とはいえ一定使えているのは興味深い。
[5] Devvrit, et al, “MatFormer: Nested Transformer for Elastic Inference,” 2024.(https://arxiv.org/abs/2310.07707)
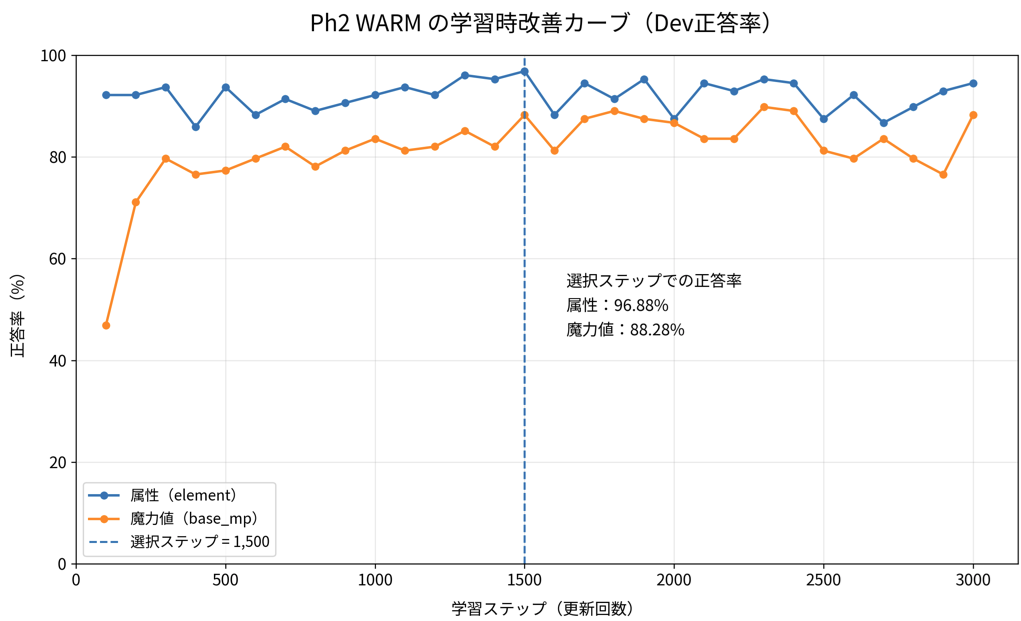
[6] 学習曲線は下記の通り。両者の性能が異なるのは偶然なのか、何らか面白い理由があるのかに興味津々。

[7] ことにする。

LLMに情報を記憶(Engram)し別モデルへ移植

前の記事では、小型の言語モデルをPost trainingし敬語変換機能を強化した。今回は少し方向を変え、記憶[1]に着目した実験を行った。LLM(Qwen/Qwen3.5-2B-Base[2])に架空の魔導書を記憶させ、その記憶を別のLLM(Qwen/Qwen3.5-4B-Base)で使えるか試してみた。

言語モデルに「記憶領域」を組み合わせるEngram(エングラム)[3]というアーキテクチャがある。短い言葉の並びを用いて学習済みの記憶領域から必要な情報を取り出し推論時に使うもので、人でいうところの記憶のような動作をする。最新のLLMであるQwen3.8-Flash-Next(N-gram Embedding)やDeepSeek-V4.1-Flash(Engram)でも取り入れられている[4][5]。また、記憶を別のモデルへ移す研究「Cross-Model Memory Transfer via Target-Side Reader Adaptation」も発表されている[6]。これは、あるモデルで作った記憶領域を別のモデルにつなぐものである。

本実験では日本語で作った架空の魔導書を使い、Qwen3.5の2Bモデルで作った記憶領域を、4Bモデルへ移してみた。Qwen3.5に追加した記憶領域はEngramを参考に独自に実装しており公式の実装ではない。

まず、4択問題で元のモデルは魔法の属性を95%、基本の消費魔力を96%正解した。これは追加したEngram型の構造により情報を記憶できていることを示唆している。次に学習した記憶を別のモデルに渡した。記憶を渡されたモデルは魔法の属性を55%、基本の消費魔力を67%の正答率で答えた。でたらめな記憶を使った場合は約25%で、四択をてきとーに答えたときと変わらない。学習した記憶は別のモデルでも(一部)使えていた。なお、記憶を差し替えると、変えなくてよい答えまで変化した。このあたりの動きもとても面白い。

記憶させる魔導書について

LLMに記憶させる情報は今まで世の中にはないものが望ましい。そのため、以前はまったプレイヤーが「言霊」と呼ばれる魔法を作れるゲーム、「ルドラの秘宝」[7]の雰囲気で架空の魔法を覚えさせることにした。(名前も設定も今回の実験用に新たに作っている)

三文字の名前を持つ512種類の魔法に、「火・水・風・土」のいずれかの属性と、1から4までの基本の消費魔力を割り当てた。例えば、次のような内容である。

魔法の名前属性基本の消費魔力
月雲霧土3
霞影夢水2
夢雲霞土1

モデルには「夢雲霞の属性は何か」「基本の消費魔力はいくつか」と質問する。前者は土、後者は1が正解になる。名前と性質は意図的に切り離している。「雲」という字があるから風属性、というようには推測できない。加えて、名前の頭に「強」を付けると、属性はそのままで消費魔力が2増える、「転」とつけると属性を次へ変更・消費魔力+1といったルールも用意した[8](が時間の都合上、一部使えなかった設定がある)。

手法

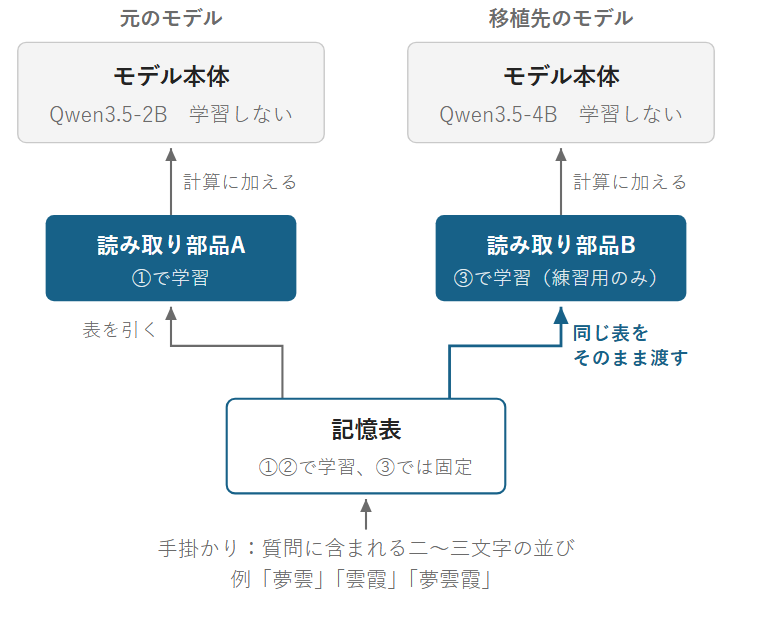
今回使うのは、Qwen3.5に独自の「記憶領域」と「読み取り部品」を追加したモデルである。記憶領域の実体は、質問に含まれる二〜三文字の並び(「夢雲」「雲霞」「夢雲霞」など)を手掛かりに、該当する行の数値を引く表である。読み取り部品は、引いた数値をモデル本体の計算に加えるためのものである。モデル本体のweightは凍結している。追加した記憶領域は約4Mパラメータ、読み取り部品は約0.4Mパラメータである。

学習は三段階に分けた。

段階学習するもの固定するもの使うデータ
① 元のモデルで学習する記憶領域・表
読み取り部品A
元のモデル本体(2B)練習用の128種類
② 知識を記憶領域に書き込む記憶領域・表元のモデル本体
読み取り部品A
448種類
(採点用の256種類を含む)
③ 移植先で読み方を調整する読み取り部品B移植先の本体(4B)
記憶領域・表
練習用の128種類のみ

②で読み取り部品を固定するのは、新しい答えを記憶領域・表以外に覚えさせないためである。③のとおり、移植先でも読み取り部品は学習している。「記憶を渡しただけで、何の調整もせず答えられた」というわけではないことに注意してほしい(とはいえ、③で採点用256種類の答えを使っていないなど変な学習が起きないよう気は使っている)。評価時には4択で答えさせておりランダムだと25%の正解率となる[9]。

比較用として、ランダムな記憶領域・表、記憶を使わない場合を用意した。ランダムな記憶領域・表を使う場合でも、学習した記憶領域・表と同じ条件で読み取り部品を学習させている。これは読み取り部品を学習させただけではスコアが上がらない確認のためである。また、魔導書の差し替え、英語での質問も試してみた。

学習では16例分をためて更新、それぞれの更新回数は2Bが基本1000回、4Bが基本3000回とした(学習対象によって一定しない)。学習にはNVIDIA RTX PRO 6000を用い、①~③の処理に約4時間30分かかった。

結果

① LLM + Engramで知識を記憶できるか? → 記憶できる

Engram型の記憶領域を組み込んだQwen3.5 2Bモデル(元モデル)は魔法の属性を95%、基本の消費魔力を96%正解した。Engram型の記憶領域を作ることで情報の記憶ができ、高い正答率で読み出せたと解釈できる。

64種類で評価属性の正答率基本の消費魔力の正答率
元のモデル(2B、記憶領域・表を作った側)95%96%

② 記憶した内容は別のモデルでも使えるか? → ある程度使える

日本語の名前を使い、日本語で質問した結果は下表の通り。記憶領域・表を渡すことでスコアが向上しているのが分かる。

渡した記憶・情報属性の正答率基本の消費魔力の正答率
学習した記憶領域・表55%67%
ランダムな記憶領域・表24%25%
記憶を使わない25%25%

一方で記憶領域・表を作った元のモデル自身の成績とはかなり差がある。

64種類で評価属性の正答率基本の消費魔力の正答率
元のモデル(2B、記憶表を作った側)95%96%
移植先のモデル(4B)59%65%

記憶領域・表への書き込みはおおむねできていて、別のモデルで読み出すところで取りこぼしていそうな結果である[10]。

③ 記憶領域を差し替えると答えも変わるか → 変わるが間違いも

次に、属性だけを変えた二冊目の魔導書に差し替えた[11]。二冊目では、採点用256種類すべての属性を「火→水→風→土→火」の順に一つずつずらしている。「夢雲霞」なら土から火に変わり、消費魔力は1のままである。本体と読み取り部品、質問文はそのままで、「別の世界になった」といった説明も加えていない。

面白いことに「夢雲霞」では、二通りの聞き方のどちらでも、正解どおりに答えが切り替わった。

「夢雲霞」の正解と回答最初の魔導書差し替え後
属性土火
基本の消費魔力11

交換の前後どちらでも正しい属性を答えられたのは3割程度。記憶領域を差し替えることで回答を変えられた事例はあるものの正直安定はしていない。

確認すること条件を満たした組数
属性が交換の前後とも正しい167/512組(33%)
消費魔力が、前後とも正しい262/512組(51%)
属性の切り替えと消費魔力の保持を同時に満たす
※「夢雲霞」のような事例
79/512組(15%)

④ 別の言語で記憶を使えるか? → 手がかりとなる情報に依存

日本語で記憶した知識を英語でも使えるか確認した。結果、名前が日本語のままなら、英語で質問しても属性の正答率は落ちなかった。英語名ではほぼランダムな結果だが、答えを含まない対応表を用意することで一部は回復した。

質問と名前の条件属性の正答率基本の消費魔力の正答率
日本語の質問・日本語名55%67%
英語の質問・日本語名59%40%
英語の質問・英語の別名27%25%
英語の別名から、日本語名の記憶へ案内する45%31%

英語の質問・日本語名の場合、属性は約4ポイント高いが、消費魔力は約27ポイント低い。属性部分の若干の性能向上、属性と消費魔力の差が言語差異によるものなのかは不明だが、とても興味深い結果である。

所感

Engramによる記憶領域の追加と記憶が他のモデルに移せるかを実験してみた。ある程度は効果がありそうでとても興味深い。

現状、新たな知識をAIに使わせる場合はRAGを使用することが多い。GraphRAG、Agentic RAG、その後のAgenticな動作のAI Memoryを含めて記憶部分をコンテキストに入れる設計は変わっていない[12]。EngramはLLM本体のweightとコンテキストの中間に位置するように見え、うまく使えるとLLMの使い勝手が向上しそうである。

この検証はGPT-6 AstraをChatGPTとCodexから使って実施したが、思い付きを実装するのが本当に楽になった。実装確認や結果確認が必須とはいえ、すごい時代になったものだと思う。

脚注

[1] LLMにおいてスキルと記憶は異なるのでは?という研究は昔からある。Knowledge Editingという分野もある。
[2] Qwen/Qwen3.5-2B-Base · Hugging Face, Qwen/Qwen3.5-4B-Base · Hugging Face、いずれもApache-2.0 ライセンス。
[3] Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. https://arxiv.org/abs/2601.07372
[4] Zihan Qiu, et al, “On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability,” 2026. https://arxiv.org/abs/2608.30320、N-gram Embeddingという名称でEngramと近い構造を持つ
[5] DeepSeek-AI, et al, “DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression,” 2026. https://arxiv.org/abs/2609.19969
[6] Mingyuan Li, et al, “Cross-Model Memory Transfer via Target-Side Reader Adaptation,” 2026. https://arxiv.org/abs/2608.17050、プロジェクトサイトはCross-Model Memory Transfer via Target-Side Reader Adaptation | OLAResearch、コードも公開(OLAResearch/XMemTransfer: Cross-Model Memory Transfer via Target-Side Reader Adaptation)されている。非常に興味深い研究。
[7] 1996年発売のゲーム(ルドラの秘宝 – Wikipedia)。VC ルドラの秘宝に言霊の説明がある。
[8] 色々と作りこみたいところではあるが、まずは実験ということでシンプルに。大枠は ChatGPT 作である。
[9] 採点では、用意した四つの回答候補から、モデルが最も答えらしいと評価したものを選んだ。採点対象は256種類の魔法で、それぞれ二通りの聞き方を使うため、属性と消費魔力を各512問で評価している。(回答候補の文字列に対する対数尤度を比較し、最大の候補を予測とした。属性は0〜3、基本の消費魔力は1〜4を候補とする。途中確認用64種類も二通りの聞き方で評価するため、各属性の分母は128問である。)
[10] 同じファミリーとはいえ異なるモデルであり、このスコア差が何から生じているか検証すると面白そうな予感がある。
[11] 二冊目の記憶表は、属性を変更したデータで別に学習して作成した。
[12] パラメータを変える手法も提案されている(Yuyang Hu, et al, “Memory in the Age of AI Agents,” 2026. https://arxiv.org/abs/2512.13564)……が、現実での利用は計算量的に厳しい。

小規模言語モデル(SLM)のPost training

最近、蒸留が可能な大規模モデルが増加している[1] 。敬語変換を対象にSLM[2]をPost trainigすることで実用的なモデルが構築可能か試してみた。結果、Post training後の2Bのモデル(Gemma-2-Llama-Swallow 2B)が10倍以上の規模のローカルLLM(Gemma 4 31B / 1-shot)を超えるだけでなく、フロンティアモデル(Claude Opus 4.6 / 1-shot)に近い性能を出すことができた。

モデル / 手法BLEUchrFLLM as a judge
Claude Opus 4.6 / 1-shot71.5475.344.69
Gemma-2-Llama-Swallow 2B / QLoRA + DPO77.2874.564.64
Gemma 4 31B / 1-shot67.3571.734.60

手法

敬語変換モデル構築を対象として、教師モデルを用いたデータ合成後、Post trainingを行うことでSLMを強化する。データ合成はペルソナやコンテキストを事前作成し参照データを使いながら複数モデルでAgenticに行う。Post trainingはFine tuningとReinforcement learningを用いる。

  1. 敬語ルールを機械可読に変換する
    文化庁が出している「敬語の指針」をAIに読み込ませ、敬語の運用原則とチェックリスト、典型的な誤用をリスト化した。このデータはデータ合成と評価ルーブリック作成に用いた。
  2. ペルソナとコンテキストの合成
    架空の氏名、会社、部署、役職、社内外関係を持つペルソナを1,000人分作成。さらにIT/SaaS、製造、物流、教育、医療、行政、小売など15ドメイン、20種類のシナリオから900件のコンテキストを作成した。
  3. メールスレッドの作成
    ペルソナとコンテキストをランダムに選択し、複数通のメールのやりとりを合成した。合成時に軽微な敬語の誤り、典型的な誤り、失礼な表現を含む状況を入れ込み教師データを作成した。これらのプロセスでは1.のデータを参照、複数のモデルをAgenticに用い相互レビューと修正を行うことで品質を高めた。
    1.、2.を含め合成時に使用したモデルはDeepSeek V4 Flash(https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash)[3]、Mistral Large 2512(https://huggingface.co/mistralai/Mistral-Large-3-675B-Instruct-2512)[4]である。
  4. Post training用データと評価ルーブリックの作成
    合成した30,000件のデータのうち29,600件をPost trainingに、200件をtraining中の検証用に、200件をテスト用に分割した[5]。評価用データには評価ルーブリックを入れ込みLLM as a judgeで判定しやすくした。評価データは全量目検証している[6]。
  5. Post trainingと評価
    合成したデータを用いてGemma-2-Llama-Swallow 2B(https://swallow-llm.github.io/gemma2-llama-swallow.ja.html)[7]とGemma 4 E2B(https://huggingface.co/google/gemma-4-E2B)[8]に対してfine tuningを行った。Gemma-2-Llama-Swallow 2BではFull Fine-TuningとQLoRAを行い、Gemma 4 E2BはUnsloth LoRAを利用した。成績の良かったGemma-2-Llama-Swallow 2B + QLoRAに対してはDPO(Direct Preference Optimization)を用いたRLを追加的に実施した[9]。学習環境はNVIDIA RTX Pro 6000である[10]。
    評価はBLEUなどの機械評価の他、GPT-5.5を用いたLLM as a judgeで行った(目検も実施している)[11]。比較対象としてGemma 4 31B(規模が大きく日本語に強いローカルモデル)とClaude Opus 4.6(フロンティアモデル)を用いた。これらは1-shot構成でCodexによるプロンプトチューニングを実施している[12]。

結果

結果は下表のとおり。最終モデルは2Bで31BのGemma 4を超え、Opus 4.6に迫る性能を出せた[13]。また、教師モデルであるMistral Large、Deepseek V4 Flash単体の性能を超えており、参照ドキュメントの活用やAgenticなデータ合成に効果があったことがうかがえる。

モデル / 手法BLEUchrFLLM as a judge
正解データ100.00100.005.00
Claude Opus 4.6 / 1-shot71.5475.344.69
Gemma-2-Llama-Swallow 2B / QLoRA + DPO77.2874.564.64
Gemma 4 31B / 1-shot67.3571.734.60
Gemma-2-Llama-Swallow 2B / QLoRA79.7682.374.60
Gemma-2-Llama-Swallow 2B / Full FT79.2182.004.53
Gemma 4 E2B / Unsloth LoRA final76.3778.604.35
Mistral Large 251249.6951.444.27
Deepseek V4 Flash52.7559.303.84
Gemma-2-Llama-Swallow 2B / Post training前44.8362.982.72
Gemma 4 E2B / Post training前16.7344.142.35

※ 太字は本件でPost trainingを行った結果。下線はPost training前の値。

所感

データ合成に50 USD、数時間の学習という規模で、2Bのモデルがフロンティアモデルのone shotに肉薄する性能となったのは正直驚きだった。敬語変換という狭く特化したタスクであるとはいえ、「蒸留可能な教師モデルで工夫したデータを合成し、SLMをPost trainingする」というレシピの費用対効果は高そう。

Kimi K3やDeepSeek V4 Flash 0731など高性能な大規模公開モデルが増加している、蒸留可能なモデルが増えてきている、SLMの性能が上がっている、APIコストが高くなってきている、…などなど最近の雰囲気からこの手のパイプラインも重要になりそう[14]。

脚注

[1] https://openrouter.ai/models?distillable=true、Open router的にはdistillableとなっているKimi K3やDeepSeek V4にとても期待が高い(実態としては利用規約を要確認)。SLMの対比としてはLLM(Large Language Model)、LRM(Large Reasoning Model)。現状だとマルチモーダル前提のモデルがほとんどで、LLMと表現して正しいのか謎な状況になっている。
[2] Small Language Model(小規模言語モデルまたは小型言語モデル)、スモールの定義はなんとなく10B以下くらいだと思うが「10Bが小規模なのか?」は謎である。
[3] 284B, 13B ActiveのLLM、MITライセンス、
DeepSeek-AI, et al, “DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence,” 2026.
[4] 675B, 41B ActiveのLLM、Apache-2 ライセンス、
Mistral AI, “Mistral Large 3 Model Card,” , 2025.
[5] データ合成で使用したコストは50 USD程度。
[6] 敬語変換の妥当性は確認、学習データとペルソナ・コンテキストの被りがないことも確認はしているが、合成データであるのでその分布とのLeakageは避けられないとは思う。
[7] 2BのSLM、https://ai.google.dev/gemma/terms & Llama3.3ライセンス(https://developer.meta.com/ai/llama3_3/license/)に沿って利用可能、
Kazuki Fujii, et al, “Continual Pre-Training for Cross-Lingual LLM Adaptation:Enhancing Japanese Language Capabilities,” in Proceedings of the First Conference on Language Modeling, 2024, pp. (to appear).
Naoaki Okazaki, et al, “Building a Large Japanese Web Corpus for Large Language Models,” in Proceedings of the First Conference on Language Modeling, 2024, pp. (to appear).
Youmi Ma, et al, “Building Instruction-Tuning Datasets from Human-Written Instructions with Open-Weight Large Language Models,” 2025.
[8] 実質5.1BのSLM、Apache-2 ライセンス、
Gemma Team, et al, “Gemma 4 Technical Report,” 2026.
[9] SFT済みadapterを出発点にDPO。強化学習では、正解メールをchosen、事実を壊す、敬語の誤用を入れる、余計な説明を混ぜる、構造を欠落させる、といったhard negativeをrejectedとした。
[10] パラメータにもよるのだろうが、長くても数時間で実行可能。SFTのみでもかなりの効果があったためRLは最終調整として実施している。
[11] データ合成時に「敬語の指針」を用い評価ルーブリックを作成しているため、LLM as a judgeと目検はほとんど整合していた。
[12] 検証時点で性能の良いものとして活用。JudgeがGPT-5.5であるため、Familyバイアスを避けるためOpenAI系列ではないものを使っている。
[13] Gemma-2-Llama-Swallow 2Bはとても性能が高い。日本語での継続学習等が効果を発揮しているように見える(このタスクとの相性もよさそうに思える)。適当なデータを入れてみた感じの動作も悪くなさそうなので、実データを使った検証をしてみたいところ。手作成データでしっかり検証したい気持ちもなくはないが、ぷるーふおぶこんせぷととしてはいったんこの結果で良いかなと思っている。(合成データの限界とLeakage疑いは避けられないのでスコアの評価は誇大広告気味である)
[14] 実際のところは良くわからないが、うまくデータ合成して使えるSLMを作るという方向性は悪くなさそうな予感。

arXiv論文整理エージェント FuguReport

論文確認時にAIを使うことが多くなっていることもあり、arXiv最新論文の紹介の完全自動化を行った。今後は「FuguReport」に引っ越す(?)[1]予定である。

FuguReportの概要と実装方針

Fugu ReportにはDaily ReportとWeekly Reportの2つがある。Daily Reportは注目すべき個別論文の紹介、Weekly Reportは週次で注目すべきテーマの紹介を行う構成にしている。大体のイメージは下表のとおりである。

Daily ReportWeekly Report
① 毎日自動作成
② 日次で注目すべき最大5論文を選びそれぞれを要約する
③ 論文の抽出はfugumtのスコアの他、他サイトの注目度を加味する[2]
① 週次で日曜日に自動作成
② 過去1週間に盛り上がった3テーマについてレポートを作成する
③ テーマの選別はfugumtのスコアの他、論文間の距離を利用して遠いテーマを選別する

両レポートともfugumtのスコアを活用している事、ライセンス関係に気を付けている事[3]、日本語と英語版の2つを作成する事は共通である。今のところ基本部分の生成にはGPT-5.4、レビュー修正にはClaude Opus 4.6を用いている[4]。なお、ツールとして独立できる部分はMCP Serverとして分離する構成にしている。次々とツール使っているAI Agentと呼んで良いアーキテクチャになっている。

Daily Reportの生成手法

Daily Reportは下記の方針で生成。オーソドックスなフローとなっている。

  1. 対象論文の選定
    • Creative Commonsライセンスか否か(および本文取得が可能か)、fugumt score、引用件数、SNSやWEBサイトでの言及数[5]などから注目すべき論文を選定
  2. メタデータと論文情報の取得
  3. 著者所属、キーワード及びその階層構造、プロジェクトサイトやgithubリポジトリなど重要情報の取得
  4. Draft(GPT-5.4)→ Review(Claude Opus 4.6)→ Translate(GPT-5.4)の 3 段階で処理

Weekly Reportの生成手法

WeeklyレポートはDaily Reportより凝った構成としている。

  1. 週次で盛り上がったテーマを選定
    • fugumt scoreをベースに対象週の候補論文群を選定
    • 候補論文群のそれぞれの論文のベクトルを求めそれぞれの距離を計算
      • Abstract、論文カテゴリ、キーワードの 3 種 embedding を取得しコサイン距離を計算[6]。
    • 3 テーマ選定、最高スコア論文を 1 テーマ目として採用し、2 本目以降は「選択されたテーマから遠くかつスコアが高い」論文を選択
      ※ テーマの多様性を確保
  2. 各テーマの代表論文の選定
    • 各テーマに関連する論文でCC ZERO、CC BY、CC BY-SAと本文が扱えるものを選定
    • 最大 10 本を比較プールに蓄積し、fugumt score、論文の意味的距離、LLM as a Judgeによる比較選定を組み合わせ、最大 3 本を決定
  3. Introduction / Future Work の抽出
    • 代表論文の本文のうち、IntroductionとFuture Workに関する部分を抽出
      ※ 全く抽出できない場合は次順位の論文を試す
  4. 段階的なレポート生成
    • テーマ現状の生成、代表論文 3 本の Introduction を中心として「主要課題」「研究の方向性」「代表論文の役割分担」を 記述
    • 週内進展の生成、テーマに属する週内論文(上位 10 件)についてテーマのどの点を前進させたかを記載
    • 展望の生成、代表論文 3 本の Future Work と週内進展を入力として「近い将来に増えそうな方向性」「技術的ボトルネック」「次の論点」を記述
  5. 別モデルによるレビューと全文リライト
    • 初稿生成とは別モデルで査読、最終版を確定
  6. 日本語翻訳
  7. インフォグラフィクス生成

週次で盛り上がったテーマ選定に力を入れたフローとなっている。この選定はLLM as a judgeでは困難であり、fugumt scoreやWEB/SNSでの反応といったProxy的な指標が重要となる。段階的な生成と別モデルによるレビューも品質向上には効果があった[7]。

所感

生成AIの品質が向上していることもありレポートのクオリティはかなり高い。しばらくはチェックしながらの運用になると思うがdevneko.jpは3月末で更新を停止する予定である。

いろいろと試していて思ったがDaily Report、Weekly Reportとも難しいのは要約そのものよりも評価に関わる部分、という印象だった。[8]。
※ここ最近のfugumt score推しは上記が原因

対象テーマ選定や対象論文選定ができれば、それ以降の処理は自動化が容易で生成品質も高い。別モデルでのレビューは効果があるので入れているもののレビュー・修正は1回で十分な印象。すごい時代になったなーと思う。

脚注

[1] もはや人が関わっていないので紹介Blogではなく整理システムになっている。
[2] 本文を扱うことが多いので基本的にCreative Commonsライセンスの論文を選択する。
[3] 本文を扱う場合はCC ZERO、CC BY、CC BY-SAの論文を使用する。v1とv2のライセンスが異なる場合もあるので取得可能な全バージョンについて確認している。
[4] 著者所属、カテゴリ、論文分類など基礎情報の整理にはGPT-4.1、GPT-4.1 nano、Mistral Small、DeepSeek V3.2を用いているなど複数のLLM/LRMを使い分けている。
[5] 一部は十分に効いていないので今後強化を行う予定。
[6] Abstractのみよりも効果があった。
[7] 英語での処理を優先しているのはコストパフォーマンスを上げるためである(元データが英語なのでできるだけ英語で扱った方が品質面で有利でありトークンも節約できる)
[8] 実際のところ人間にも難しい。(が、これは凄い!と思う直観が働くことは少なからずある。AIの能力向上でこのあたりも解決するかもしれない。)

arXiv論文と引用の関係、fugumt scoreの検証

前記事の分析時にarXiv論文のソースファイルを取得したので、bibファイルを用いてarXiv論文内で引用がどのように行われているか分析してみた[1]。結果として注目論文を引用した論文が出るまで2-3か月というスピード感、および、fugumtのscoreによる判別力が高注目論文でROC AUCで0.8を超えまずまずの水準であることが分かった。

分析と結果

分析は以下のように実施した。bibファイルを用いて行っているため実際に本文引用されているかは保証していない[2]。また分析対象はAI関連かつソースファイルを取得可能な論文に限られる点にも注意が必要である。

  1. 2024年1月から2025年12月までのarXiv論文についてそのソースを取得し、bibファイルを抽出する[3]。
  2. bibファイルからarXiv IDを抜き出す。
    ※ このIDを引用された論文とみなす[4]。
  3. 引用状況について、発表された論文がどの程度前の論文を引用しているかを分析する。2024年1月から2025年12月のarXiv論文が引用した論文について、被引用論文の発表時期をヒートマップで表す。
  4. 2024年1月から2024年12月に発表された論文についてそのスコアと一定期間後の引用数を集計し、スコアが引用数の予測に役立つかを分析する。

arXiv論文の引用状況

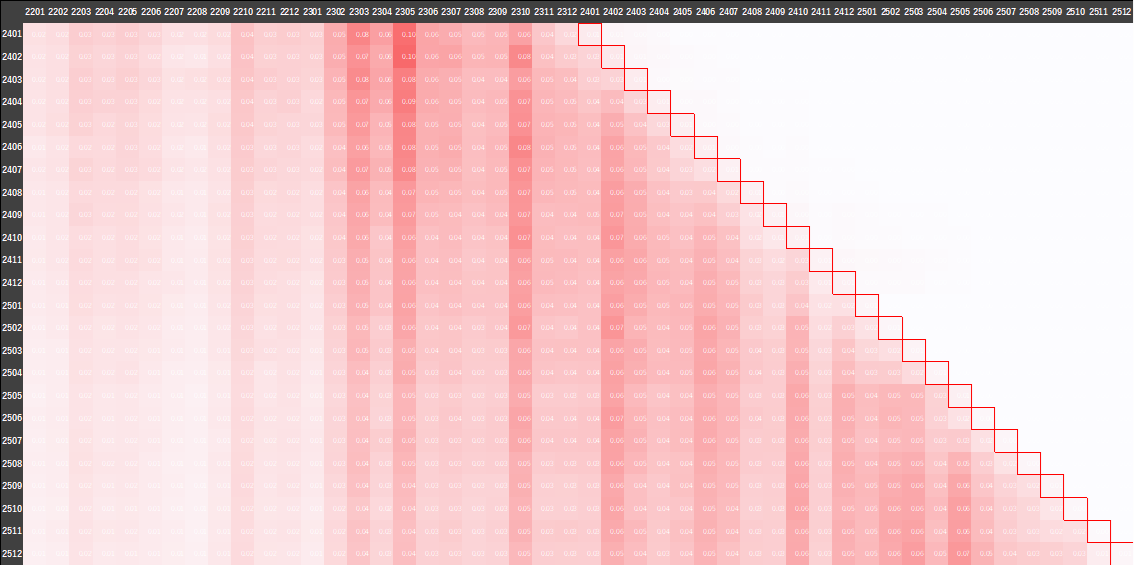
縦軸を論文発表月、横軸を被引用論文の発表月としてその数を集計、全引用数からの割合を算出すると下図のようになる。赤枠になっているのは論文発表月=被引用論文発表月になるマスであり、その右にはタイムラインの関係で論文は出ていないはずである[5]。(ヒートマップには2025年のデータも含めて描画している)

論文の被引用回数を集計すると一部の論文が突出して引用されている。それがうっすらと縦線が見える理由である。例えば2024年10月(横軸=2410)に見える縦線には[2410.21276] GPT-4o System Cardが、2025年5月(横軸=2505)に見える縦線には[2505.09388] Qwen3 Technical Reportが大きく影響している。

縦線が濃くなっていく過程(=注目論文の引用数が増えていく過程)を見ると、上記のような影響度の高い論文が出てからだいたい2-3か月でそれらを引用する論文が発表されているようである[6]。

fugumt scoreの判別力

fugumt scoreの品質を検証するため、短期間(論文発表後3か月)、長期間(論文発表後12か月)でスコアとその後の引用数の関係を分析した。結果として発表後3か月で高い引用数になる論文をスクリーニングする上で一定の効果があることが分かった。

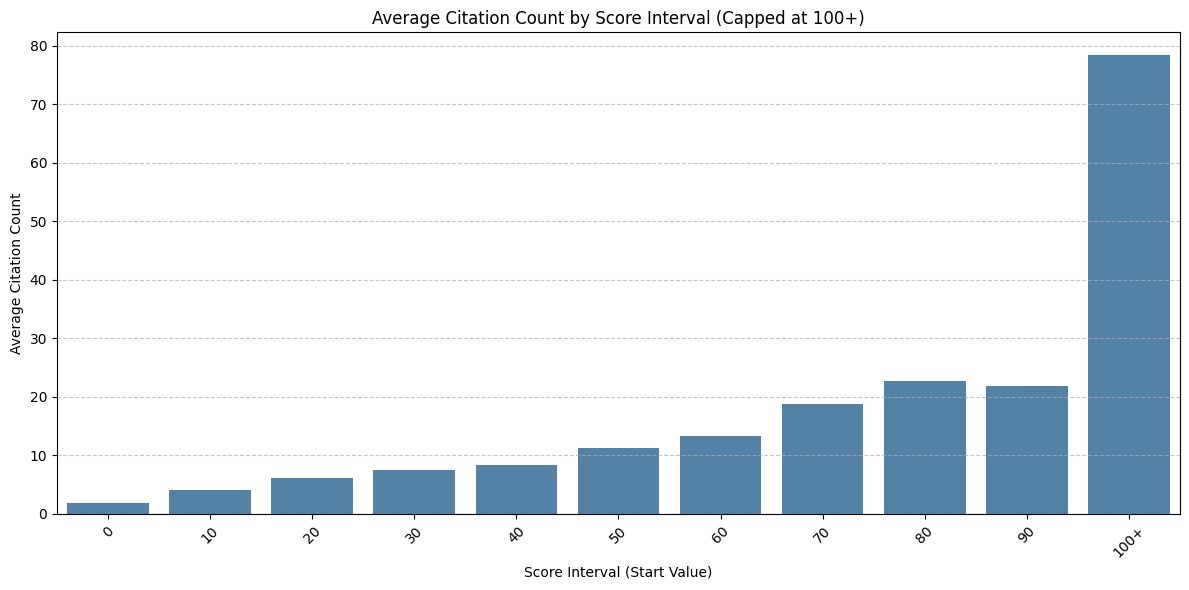
下図のように長期間でもスコアと平均引用数はまずます良い関係にありそう[7]。
※スコア100超は前述のヒートマップで線が見えるような極めて引用数の多い論文が含まれるので注意が必要(もっともそれを予測できているともいえる)

  • == 分析対象期間: 3_months (公開から 3 ヶ月以内) ===
    • データ数 (n): 107,281 件
    • ROC-AUC (被引用数 > 0): 0.6520
    • ROC-AUC (被引用数 >= 10): 0.8100
      • 10回以上引用された割合: 1.08% (1,159件)
  • === 分析対象期間: 1_year (公開から 12 ヶ月以内) ===
    • データ数 (n): 107,281 件
    • ROC-AUC (被引用数 > 0): 0.6566
    • ROC-AUC (被引用数 >= 10): 0.7528
      • 10回以上引用された割合: 9.86% (10,576件)

所感

bibファイルからarXiv内の引用関係を分析してみた。現状、重要な論文が出ると3か月程度でその論文の引用数が増加するようである。国際会議を待てない現状に沿った結果になっていて、AI研究のスピード感がすごいことが分かる。

論文を探すうえでは当初3か月程度はfugumt scoreのような代替指標が必要になるかもしれないが、それ以降は引用数を使ってもよさそうに思えた。1年程度すれば国際会議発表を引用する事例が支配的になるはずで短期、中期、長期で指標を変えるのがよさそうである[8]。

脚注

[1] あくまでarXiv内の分析となっている。国際会議等で発表後はそれを引用することが多いため参考程度の情報。もっとも3か月というスピード感ではarXivを引用することが多いと思われるので実態には近いと思っている。
[2] 引用していないとしても参照していることは確かで意味はあると思っている。
[3] 発表月の判定はarXiv ID(.の前の4桁の数字)で行っている。
[4] 主要論文についてはこの処理で引用数として概ね妥当な数が出ることを確認している。
[5] 実際はID抽出時のノイズやバージョン差異の状況などにより0にはならない。が概ね良い結果になっている。
[6] 肌感にも合うが本当にスピードが速い。
[7] ROC AUC > 0.75はあるものの短期に比べROC AUCが低くなっている。これは国際会議を通した引用等によってarXivを参照することが減っていくことと整合的に思える。
[8] 短期は3か月未満、中期は半年程度、長期は1年以上を想定している。

arXiv論文の分析(研究機関別分析)

5年間以上運営しているFugu-MT: arxivの論文翻訳(概要)に関連しarXivデータを用いた研究機関別の分析を行った。分析データ構築からLLMを積極的に活用[1]、各研究機関の違いなど興味深い結果が出た[2]。

分析の方法

研究機関別の状況を分析するため、まずはarXivデータを基礎として著者所属の取得と論文のカテゴリ判定を実施した。fugumt.comで付与しているスコアも利用し分析を進める手順とした。基礎データ作成時にはコスト削減のための工夫を行っている[3]。基礎データ作成後の分析はChatGPT(GPT-5.4 Pro)とClaude(Sonnet 4.6拡張)に任せた[4]。

  1. arXivのTeXデータをダウンロード、main部分のTeXソースを取得し、著者情報や所属が書かれていると思われる部分をヒューリスティックに取得する。
  2. 取得した情報からLLMで著者情報、所属を取得する。さらにLLMを用いて表記ゆれを排除する。
  3. 取得が失敗した論文についてはPDFデータをダウンロードしテキスト抽出処理を行う。
    ※PDFから抽出したテキストと画像データをLLMに投入、著者情報と所属を取得、LLMを用いて表記ゆれに対処する。
  4. fugumt.comで収集した論文情報(著者一覧、アブストラクト)を用いて各論文をスコアリングする[5]。加えてアブストラクトから論文カテゴリとキーワードを抽出、LLMを用いて上位カテゴリを推定、3階層の構造に変換する。
    ※ Fugu-MT:arXivの最新論文 のスコアが70を超える論文にarXiv over_70というフラグを付けている。
  5. 著者、所属、キーワード、カテゴリについてマッピングテーブルを用いて表記を統一する[6]。
    ※LLMのみでは対応の難しい表記ゆれに対処する。
  6. 整理したデータをChatGPTとClaudeで分析する。

基礎データ構築は「数十万本の多様な論文を様々な手法で整理する」という泥臭く大変な作業だった…ということで6.の分析は既存ツールに任せている。大変な部分は人間が実施、面白いところはAIが実施と、いかにも今っぽい分業になっている。

分析結果

AIによる分析結果は次の通り。全体的に面白く[7]、下記の言い切りはなかなか凄いと思う。スコアリングや集計方法による影響もあるが、新規参集の研究者が増えている傾向、重要論文の比率が相対的に下がっているのではないか?という懸念など一定の納得感がある。

「論文が増えれば影響力のある研究も増える」とは限らない。2025年は明確に、投稿量の膨張が注目度の成長を上回った年だった。

over_70比率:18.6%(2024)→ 15.7%(2025)、−2.9pt

ぜひ、分析結果とプレゼンテーション資料を見ていただきたい。

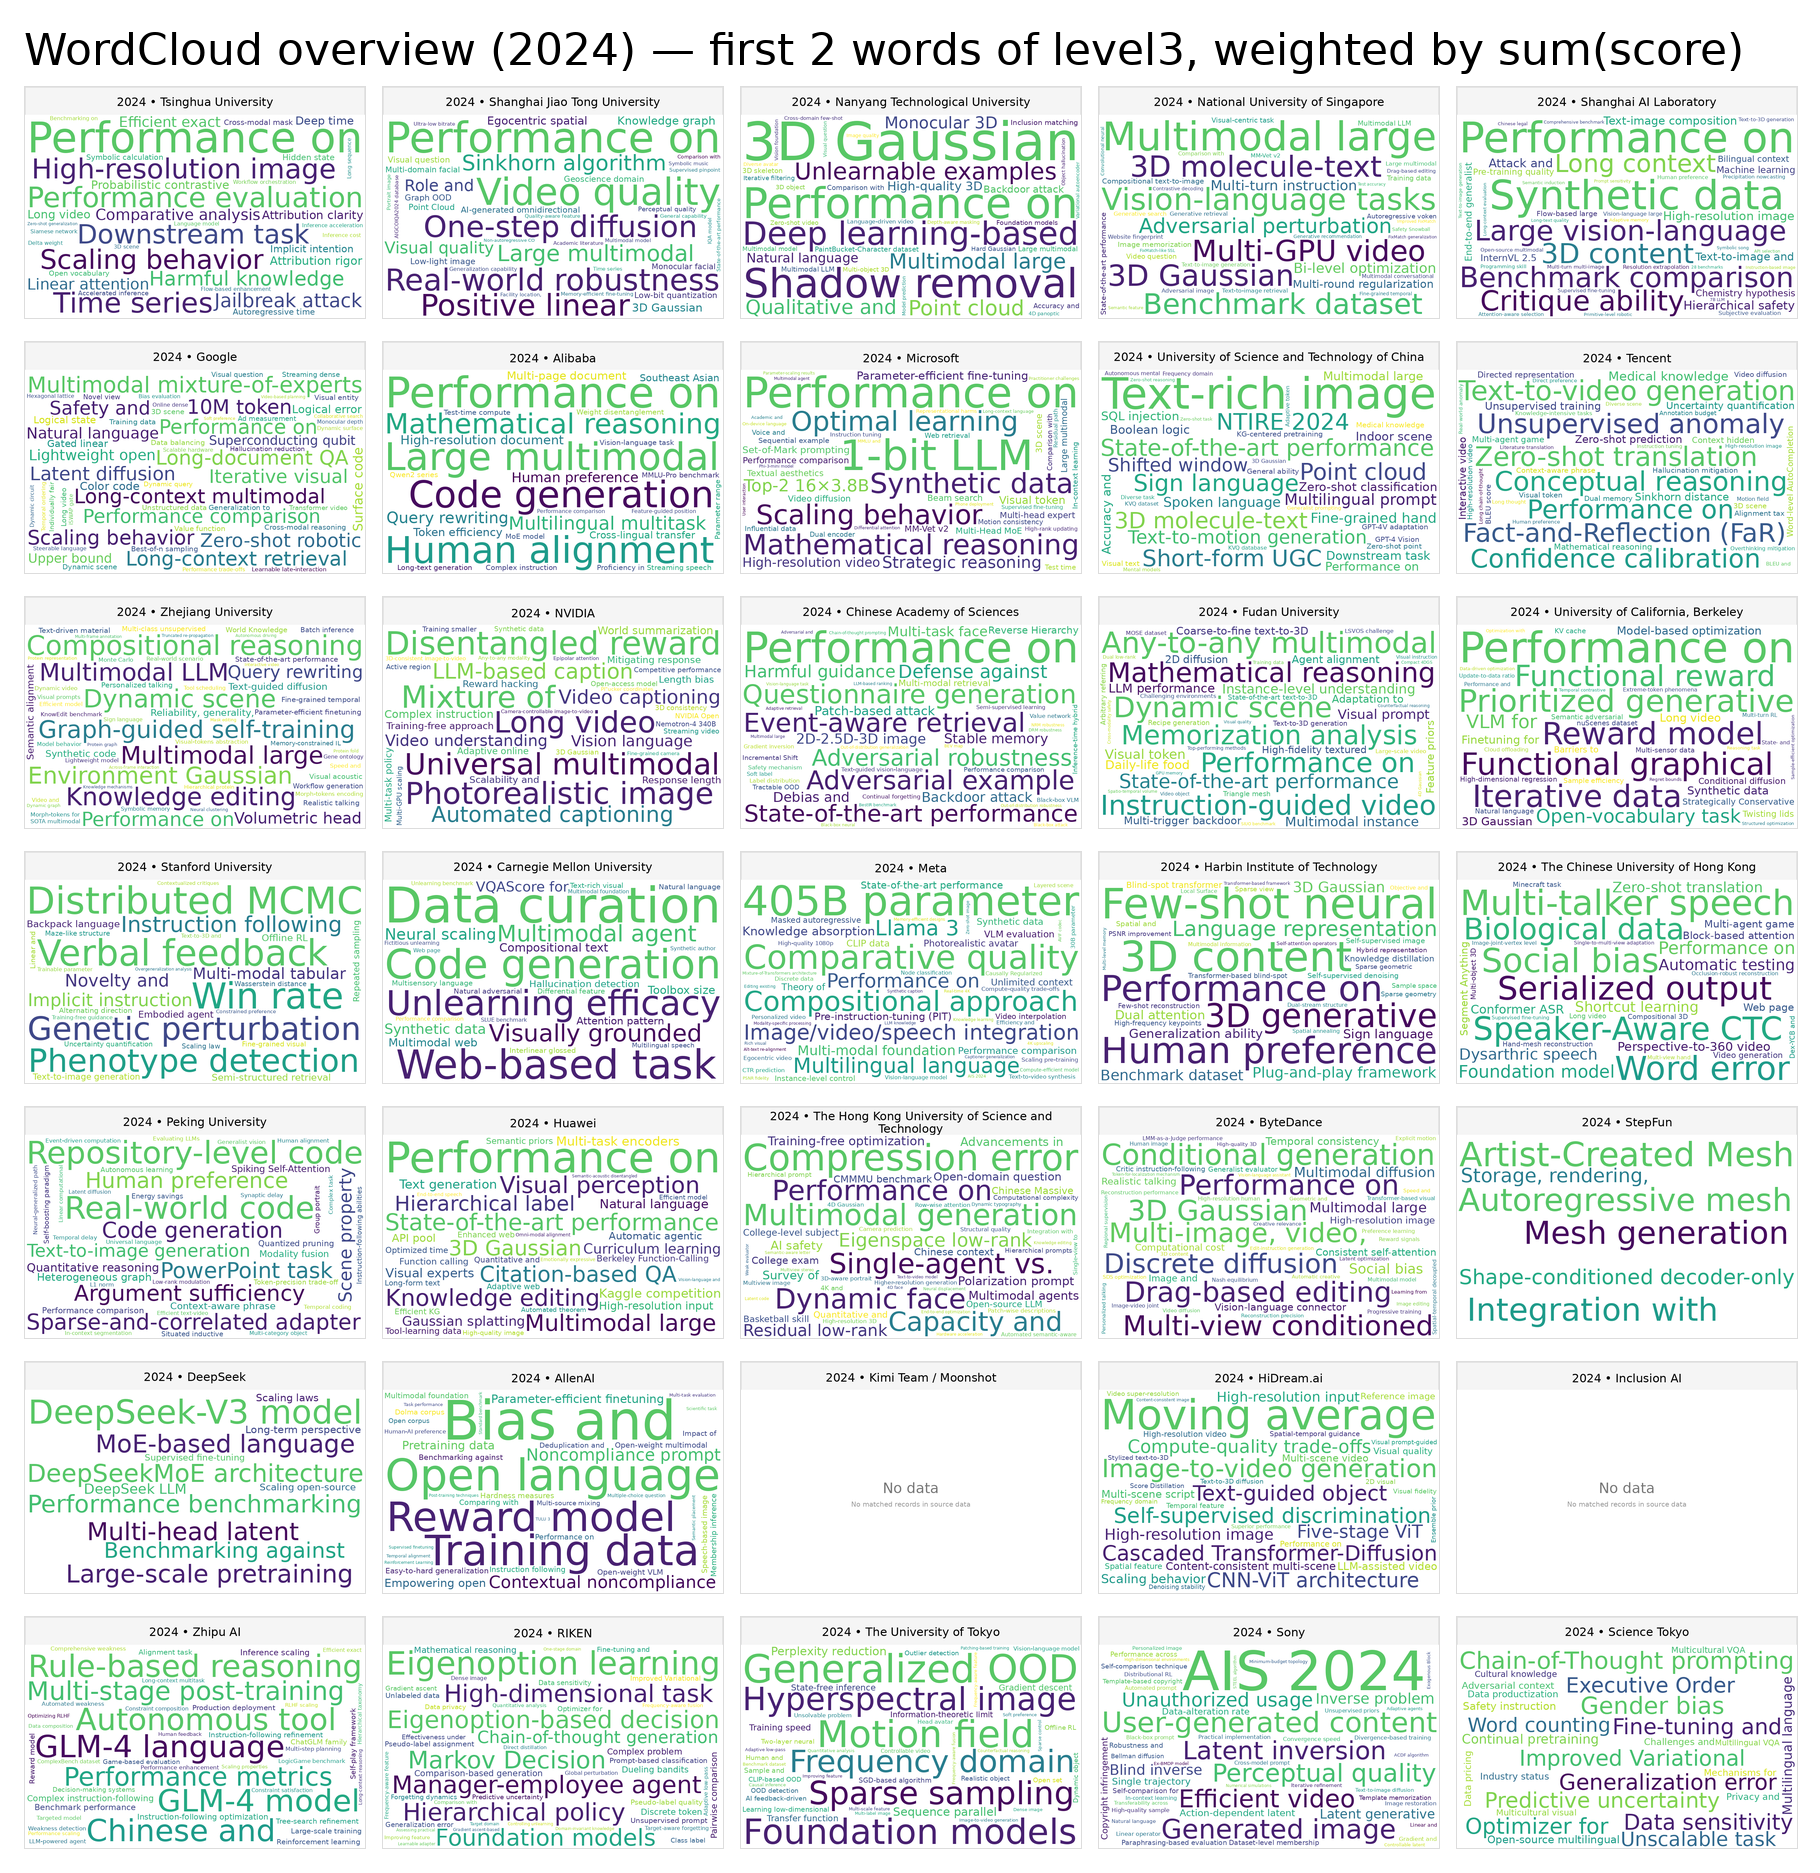
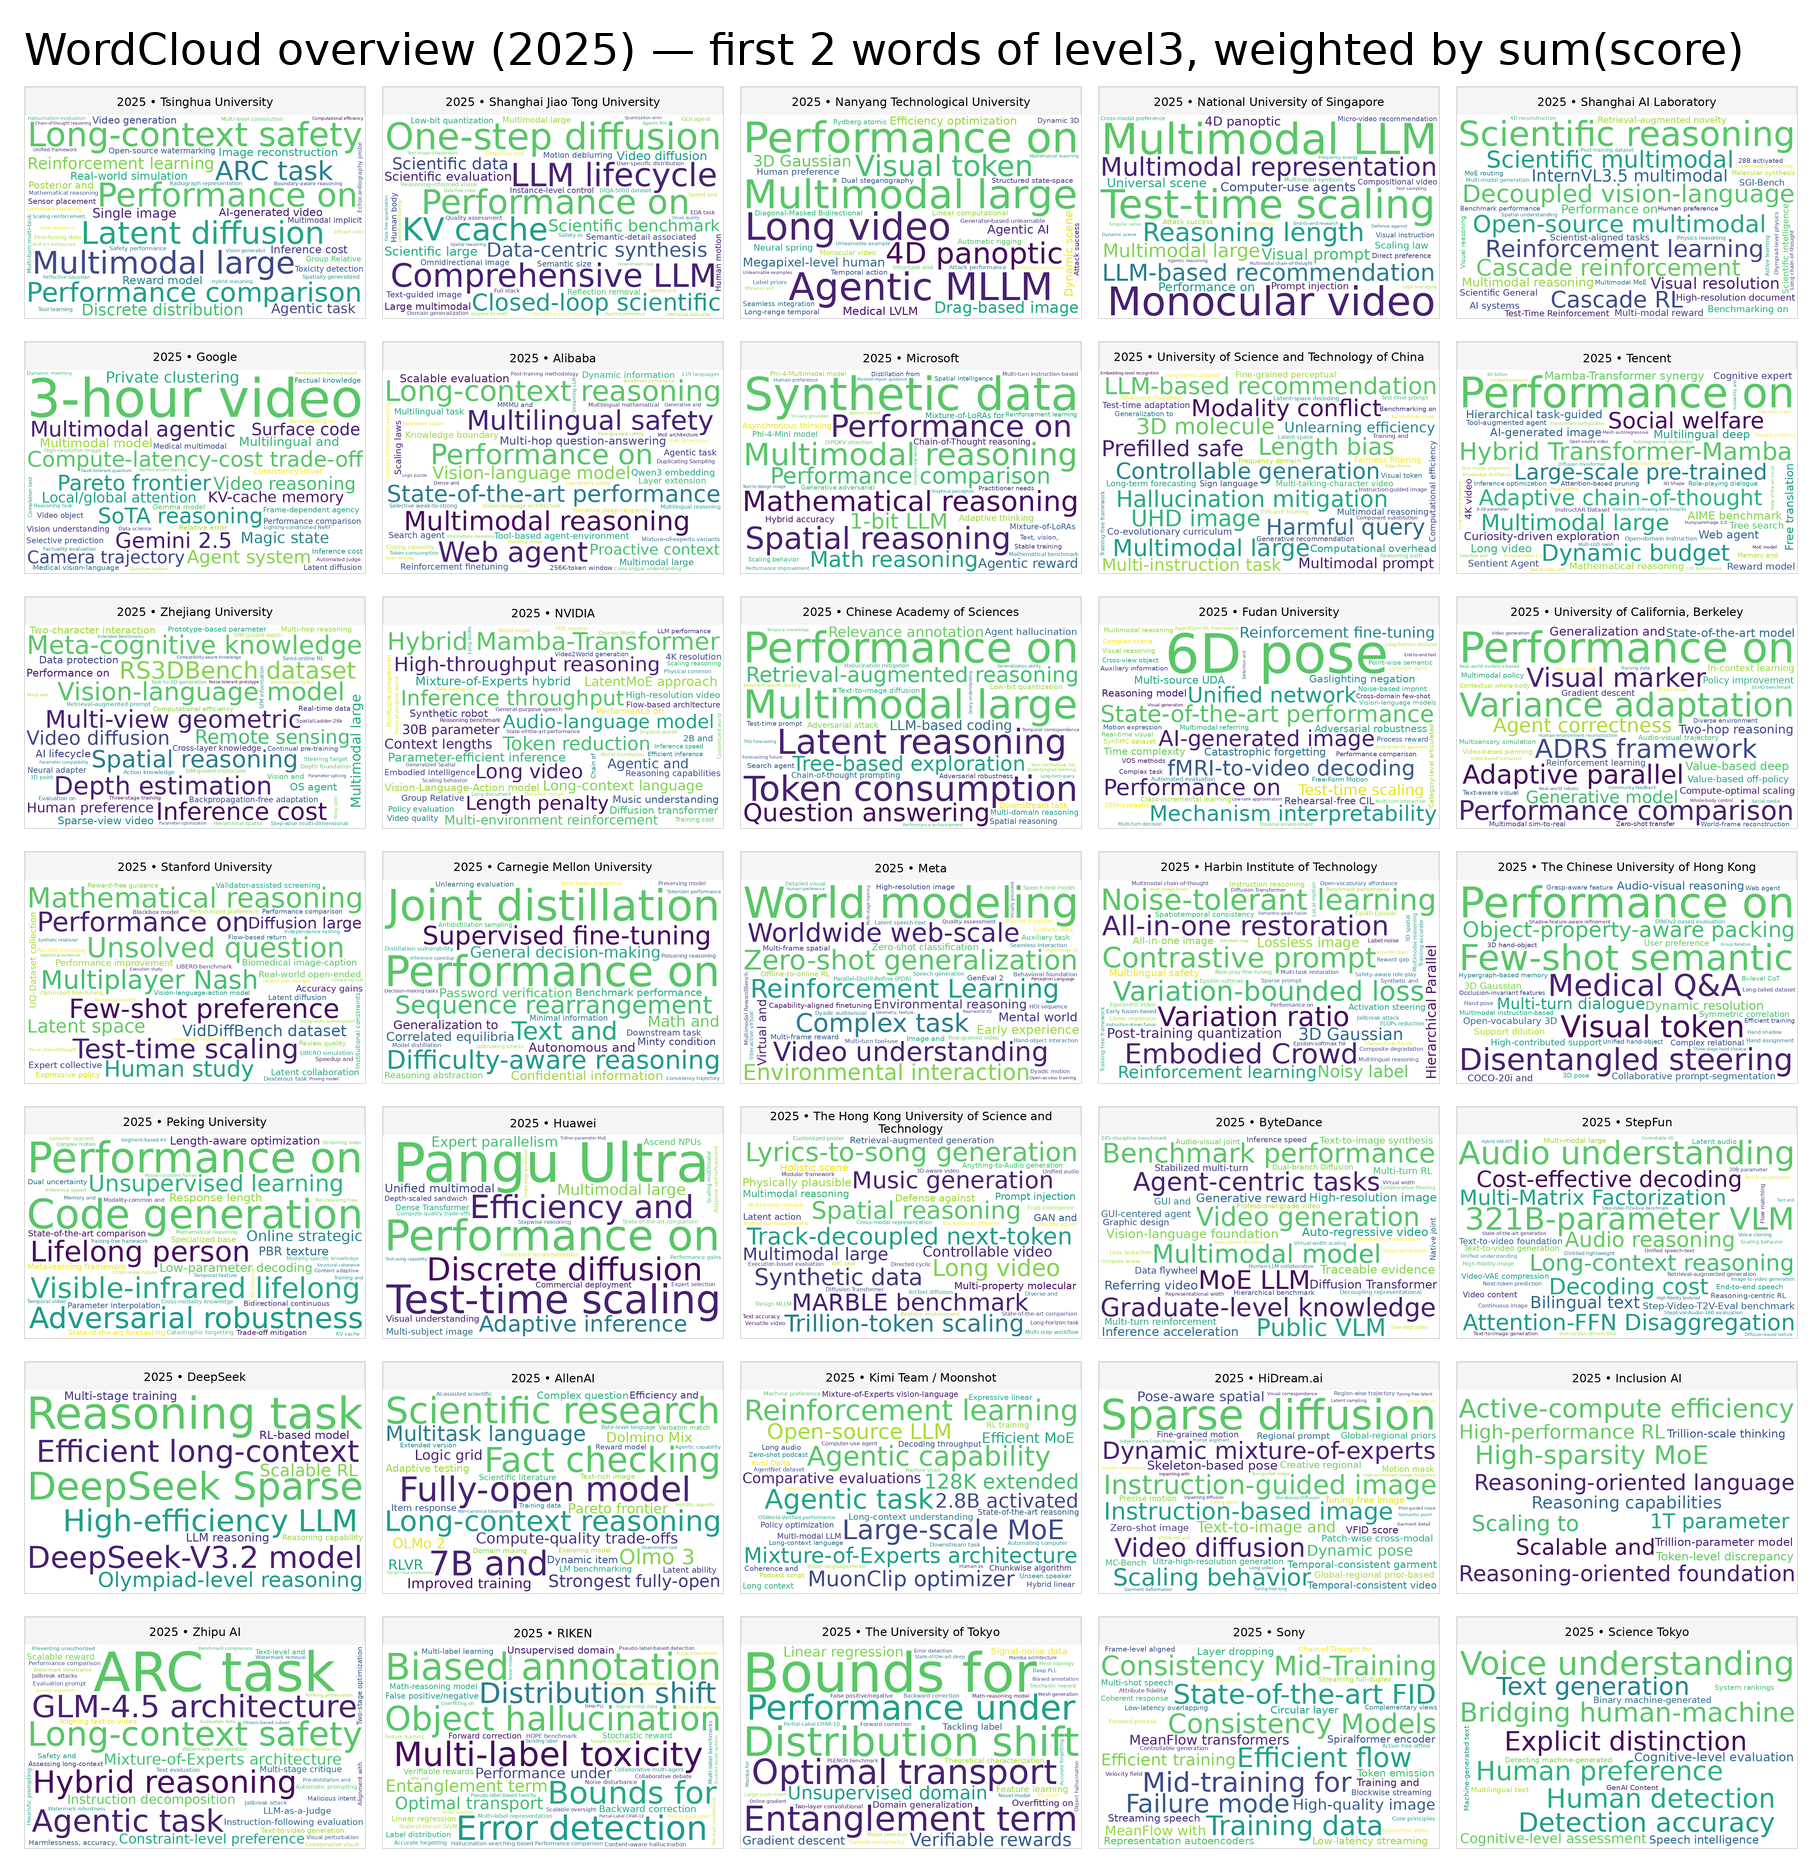
世界のAI研究機関、いま何で戦っているのか — arXiv × NeurIPS データで読み解く2025年の研究地図 (プレゼンテーション資料:arxiv_report_2025_ja.pdf、2024年のワードクラウド、2025年のワードクラウド)

せっかくなので英語版も作ってもらった。Who’s Winning the AI Research Race, and How — Mapping 2025 Through arXiv and NeurIPS Data(arxiv_report_2025_en.pdf)

特に下記、研究ポートフォリオの分析結果はなかなか興味深い。

大学・企業・スタートアップ
セクター別の戦い方

企業:LLMを核にEfficiencyとRLに賭ける

Microsoft・NVIDIA・Google・Alibaba・Tencent——いずれもポートフォリオの30〜36%をLLM/Foundation Modelsが占める。その上に何を重ねるかで差が出る。MicrosoftはEfficiency(15%)と評価(21%)の三位一体、NVIDIAはEfficiency(14%)とScaling(18%)で推論インフラを強化、AlibabaはRL/Agents(18%)でQwen系のagentic拡張に注力している。

大学:評価・ベンチマークが共通の主軸

上位6大学(清華・SJTU・NUS・Berkeley・Stanford・Fudan)のカテゴリ分布を並べると、すべての大学でEval/Benchmarkが最大テーマ(31〜44%)という共通点が際立つ。大学が「評価インフラ」を担うというエコシステム上の役割分担が、データに明確に表れている。差異はその外側にある。BerkeleyはRL/Agents(11%)とScaling(8%)が高く、embodied AI・sim-to-realの先端を行く。Stanfordは評価設計・Preference Optimizationを軸に agent の研究ループを主導。Fudanの Eval 44% は大学群で最大の特化度だ。

スタートアップ:NeurIPSを待たず、戦略は今見えている

スタートアップ各社の研究ポートフォリオは、一枚岩ではない。大きく二極に分かれている。

総合型:StepFunはLLM・Efficiency・GenAI/Videoを同時に展開し、既存大手に最も近いbroad portfolioを持つ。Kimi/MoonshotはMoE・長文・agentic benchmarkを前面に出しEfficiency 25%が際立つ。

極特化型:DeepSeekはLLM+RL+Evalの3テーマだけで構成され、reasoning・attentionへの集中度は全機関中最大。HiDreamはGenAI/Video 63%と完全な diffusion/media 特化だ。

所感

分析はChatGPTとClaudeに任せたものの「③ 新興勢の発見はNeurIPSを待たない
 StepFun・Inclusion AI・DeepSeek——これらはarXiv over_70で先に信号を出した。査読会議への反映は6〜18ヶ月遅れる。先行指標として over_70 を使えば、競合分析の精度が上がる。」とFugu-MT: arxivの論文翻訳の有効性を示したのは少し嬉しかった[8]。

大学と企業の違いであるとか、研究ポートフォリオ構成はなかなか面白い示唆だと思う。著者別の分析や共同研究の状況など細かく見ていると様々な発見がありそう。もっとも見方によってスコア分割の方法などを決めないといけないなど細かい部分はChatGPT、Claudeとも今一歩という印象がある。時間があれば私自身の手でも分析してみたい。

今っぽいと言いつつ「大変な部分は人間が実施、面白いところはAIが実施」が一般化すると嫌だなーと思う。泥臭い部分を含めてAIに任せられる日は来るのだろうか…[9]

脚注

[1] データ準備段階では所属研究機関抽出と表記ゆれの解消、論文カテゴリとキーワードの分類、階層構造の作成などに活用。データ分析自体は完全にAIにまかせた。これらを処理するプログラム作成は概ねCodexにまかせている。
[2] 若干無理のある仮定はあるが、大きな認識のずれはない。
[3] 分析予算は上限1000USD。かかったコストはAWSからの転送コストとLLM APIの利用料が主。PDFから著者情報を取得するアプローチ(3.)だとコストが10倍以上かかると予想されたため現状のパイプラインとなっている。
[4] 様々な角度からの集計や分析はGPT-5.4 Proの強さが目立ち、プレゼンテーション作成はClaude Sonnet 4.6のうまさが目立った印象。
[5] 論文著者の過去の実績(主としてトップカンファレンスでの採録数)をベースにスコアを決めている。論文内容自体の評価でない点には要注意ではある。
[6] マッピングテーブルはヒューリスティックな手法、ルール(典型的なノイズ削除)に加え、LLMの内部知識の活用とそのチェックなど、複数手法を組み合わせて作成している。
[7] ストーリーやメッセージの甘さなど指摘事項は多数あるとはいえ、読み物として面白い。
[8] fugumtのスコアリングも過去のカンファレンス実績をベースにしているのでやや誇大広告ではある。ただ、先行指標としては有効なのは本当。研究機関のスコアと次の年のNeurIPS発表数の相関係数はかなり高く、over_70の相関係数はさらに高くなる(1年後としてr=0.744)。ランキングの評価ではHuggingFace Daily papersと比較してROC AUC > 0.8など注目論文のproxy的な指標としてもまずまずの性能。発表後3か月で引用数10を超える(arXiv内でTOP 1%の論文)の判別力もROCAUC > 0.8。AIのように動きの速い分野では研究機関別のトラックレコードを見るよりも研究者の動向、共同研究の動向や所属の変化を見たほうが実態に近くなる。(とはいえ研究の質とまで言い切るのは危険。他に良いProxy指標が無いので無理を承知で使ってみたというのが実態に近い。)
[9] それはそれで人間がいらなくなる未来になってしまうわけだが・・・

arXiv AI論文翻訳サイトのMCP対応

Fugu-MT: arxivの論文翻訳(概要)をMCP(Model Context Protocol [1] )に対応させた。実装にはGradio(Building Mcp Server With Gradio)を使っている。Claude desktopからも接続ができ便利である。

Gradio[mcp]

fugumt.comのMCP対応にはgradio[mcp] [2] を用いた。gradioでは 「(1) included a detailed docstring for our function, and (2) set mcp_server=True  in  .launch()」 とするだけでMCP serverを実装できる。具体的なコードは

def search_papers(keywords: str, start: str, end: str):
    """arXivのAI関連論文を検索しMarkdownで返します。AI関連論文のみのデータベースなので検索キーワードは5個以下にすることをお勧めします。現状はベクトル検索に対応していません。
    
    Args:
        keywords: 検索用の単語リスト。" "スペース区切りを想定。全てが必須のキーワードで3 - 5 wordsが推奨値。
        start: 検索の開始日。yyyy-mm-dd表記を想定。この日付以降の論文を検索。
        end: 検索の終了日。yyyy-mm-dd表記を想定。この日付以前の論文を検索。
    """

である。上記に対応してmcpsearch.fugumt.com/gradio_api/mcp/schemaのようにschemaが作られる。使用方法などはhttps://mcpsearch.fugumt.com/?view=apiから確認できる [3] 。

Claude desktopでの利用例

Claude desktopでfugumtのMCP serverを利用するにはFor Claude Desktop Users – Model Context Protocolのようにセットアップし、「claude_desktop_config.json」に下記設定を行えばよい。

{ 
  "mcpServers": {
    "fugumt": {
      "command": "npx",
      "args": [
        "mcp-remote",
        "https://mcpsearch.fugumt.com/gradio_api/mcp/sse"
      ]
    }
  }
}

Building Mcp Server With Gradioの3.に書かれているように「Some MCP Clients, notably Claude Desktop, do not yet support SSE-based MCP Servers. In those cases, you can use a tool such as mcp-remote. First install Node.js. 」であるため、Claude desktop利用時はNode.jsのインストールも必要である [4]。

実行例は下記の通り。

fugumt.comのMCPサーバを利用した応答ができている(https://claude.ai/share/f19d4dda-e264-4486-a3ad-0af1d723ed76)。

gradioを使うと非常に簡単にMCP serverを実装できる。arXivのAI関連論文を検索を含めてarXiv論文を探す場合にぜひ利用してほしい [5]。

脚注

[1] AIアシスタント(LLMアプリケーション)がデータソースやツールと連携するためのプロトコル(Introducing the Model Context Protocol \ Anthropic)
[2] Building Mcp Server With Gradioの通り。
[3] 使用方法などドキュメントを含めて自動生成されるのはとても便利。
[4] クライアントによっては「”url”: “https://mcpsearch.fugumt.com/gradio_api/mcp/sse”」の記載でOKのよう。
[5] と言いつつ安定稼働はしていないと思われる… vector searchへの対応や関連論文リスト取得をサポートするなど拡張もしていきたいと思っている。

OpenManusを使ったサイトへのエージェント組み込み

Introducing Operator | OpenAIに支援してもらう飲み会[1]が面白かったのと、Manusが流行っていることもあって、FuguMTへのエージェント組み込みを試してみた。OpenManus[2] を用い、下記の動作を実装している。

  1. ユーザによるリクエストを受け付ける
  2. OpenManusを用いてリクエストを処理する
    • OpenManusをFuguMTに特化した動作を行うようにカスタマイズ[3]
    • fugumt.com以外のサイトへはアクセスしないよう制御
  3. 処理過程(Linuxデスクトップの動作)を適時スクリーンショットしてブラウザに表示する

実際の動作例は下記の通り。エージェントへの入力以降の処理、ブラウザの立ち上げや使用するツール選定、ツールの操作などはOpenManusが行っている[4]。WEBアプリとして実装しており、ブラウザの中でブラウザが立ち上がっているような不思議な光景となっている。

OpenManusの基本性能は高く見ていて面白い。OpenAIのOperatorでは(fugumt.comのようなマイナーな)個別サイトの構成や機能を知ることは難しい。個別サイトで用意されたエージェントとOperatorが会話、マルチエージェント的に協調する将来もあるのではないかと思う[5]。そこまでいかなくてもユーザからの問い合わせに対応してくれるエージェントはとても便利[6]。エージェントがブラウザを操作するため、サイト側での開発が必要ない点は大きなメリットである。

OpenManusのようなOSSなエージェントフレームワークは増えていくことが予想される。LLM based Agentを用いると個別にシステム開発するよりも多様なニーズに対応しやすい。このようなエージェントは今後様々なサイトに導入されていくであろう[7]。

一時的に[8] Fugu-MT:Agentで実行可能としているので興味のある方は試してほしい。

脚注

[1] 実際に注文をOperatorにやってもらった。ブラウザ対応の注文インタフェースをもつ居酒屋は多い。竜田揚げを人数分頼もうとしたり、やたら枝豆を頼もうとしたり、なかなか面白い挙動をしていた。Operatorによるとホッケに合うお酒は新政らしい。(先行事例としてみんなで飲みにいくんですけど、Devinさんも来ます? – Devin観察日記|Daiki Teramotoがある)
[2] GitHub – mannaandpoem/OpenManus: No fortress, purely open ground. OpenManus is Coming. MITライセンスのOSS
[3] fugumt.comのサイト構造、URL構成、提供しているツールの使い方などを事前設定している。これによってOpenManusのタスク達成率がかなり上がる。
[4] MLLMとしてGPT-4oを使用している。
[5] Operator用のナビゲーションファイルを置いておけばよいという説もある。AI Agent用のrobots.txt的なものが必要なのでは?という議論は多い。LLM用だとThe /llms.txt file – llms-txtだが、もっとヴィジュアルになっていくんだろうか。
[6] わざわざブラウザ使わなくても良いのではないかという説もある。
[7] すごく流行るかは微妙なところだが可能性は感じた。fugumt.comのような小さな個人サイトでも必要な機能を個別に作っていくより処理内容を自然言語でAIエージェントに指示しておく方が楽かもと思う。(処理時間やコストや色々と無駄など諸々の問題はあるが…)
[8] APIのコストが高いので限定公開の予定。

CyberAgentLM3-22B-Chat (CALM3-22B-Chat)の機械翻訳性能

公式のニュースリリースや論文発表はされていない気がするが[1]、HuggingFaceリポジトリでCALM3 22Bが公開されていた(cyberagent/calm3-22b-chat · Hugging Face)

いつもの設定で機械翻訳性能を検証してみた。性能評価に使用したデータは以前(DAMO PolyLM-13Bの機械翻訳性能 | ぷるーふおぶこんせぷと (staka.jp))と同じ。検証環境は環境はColab Pro+ (A100)を用いリポジトリの推奨設定[2]でロードしている。

前回のGemma 2 9Bと同様に余計なトークンが入ることが少なく[3] GPT-4oを用いた回答部分の特定は行っていない。評価指標はBLEU、使用したツールやtokenizerは以前と同じ(sacrebleu –tokenize ja-mecab)である。「0 shot」と「1 shot」の比較でICLやRAGなどプロンプト内にデータを与えた時の性能をザックリとみる事ができる。いつもの通り非常に限定された機械翻訳ベンチマークであることに注意が必要である。

モデル0 shot1 shot
cyberagent/calm3-22b-chat · Hugging Face24.738.9
CALM3-22B-Chatの機械翻訳性能(BLEU)

結果と所感

Gemma 2 9Bと比べると評価が難しいが性能はかなり高い。Gemma 2 9Bとのスコア差は今使っているベンチマークが機能していない可能性高く要再検証であると思う[4]。

日本の会社による高性能LLMがApache 2ライセンスで公開されている意義は大きい。他のベンチマークでの検証結果も気になるところ[5]。

脚注

[1] Xでは話題になっている。
[2] model = AutoModelForCausalLM.from_pretrained(“cyberagent/calm3-22b-chat”, device_map=”auto”, torch_dtype=”auto”)
[3] <|im_start|>assistant ~ <|im_end|>をとる方針で十分だった。
[4] 外務省のページが自動取得不可になったようで他の省庁のデータでベンチマークを再構成中
[5] Nejumi LLMリーダーボード3 | llm-leaderboard3 – Weights & Biases (wandb.ai) はかなり参考になる