前の記事では、Qwen3.5 2Bに架空の魔導書を記憶させ、その記憶をQwen3.5 4Bで使えるか試した。結果、一部は使えていそうだが、移植元と移植先で大きな性能差があった。今回は大小のモデルが重みを共有していたら記憶の移植がしやすいのでは?という仮説に基づき、マトリョーシカ構造[1]のGemma 3n [2]を用いて前回同様の実験[3]を行った。
結果、移植元のモデルは属性98.24%、基本の消費魔力94.53%を正解、移植後のモデルで読み方を調整すると91.99%、89.06%正解した。移植元と移植先で差異はあるものの前回より大きく改善している。なお、読み方を調整せずそのまま接続すると59.18%、28.71%で課題が残った[4]。
ベースモデルの構造・マトリョーシカ構造
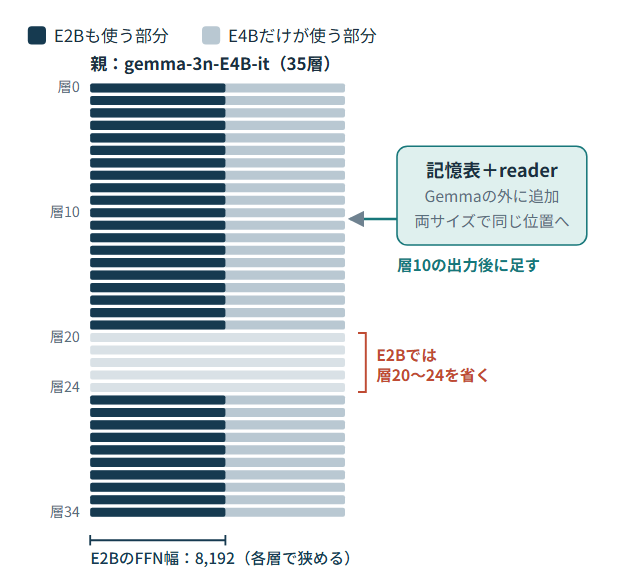
マトリョーシカ構造は大きなモデルの中に小さなモデルが内包され、マトリョーシカ人形のような構造をしている。Gemma 3nはMatFormer[5]を利用しており、大きいE4Bの中に、小さいE2Bのパラメータを含んでいる。今回はgoogle/gemma-3n-E4B-itを親として、E2B構成を切り出して使った(下図参照)。このようなアーキテクチャを用いることでE2B→E4Bの知識移植が効率的に行えないかを検証する。
モデルに記憶させるもの
基本的な構成は前回同様である。記憶する魔導書は「ルドラの秘宝」の言霊から着想を得た実験用のものである。三文字の魔法名を根底語とし、「火・水・風・土」の属性と、1から4までの基本の消費魔力を割り当てている。全512種類を、練習用128種類、途中確認用64種類、採点用256種類、(未登録64種類)に分けた。今回は基本情報を直接尋ねる問題に絞っている。前回と異なり魔導書の差し替えや英語での質問は評価していない。
手法
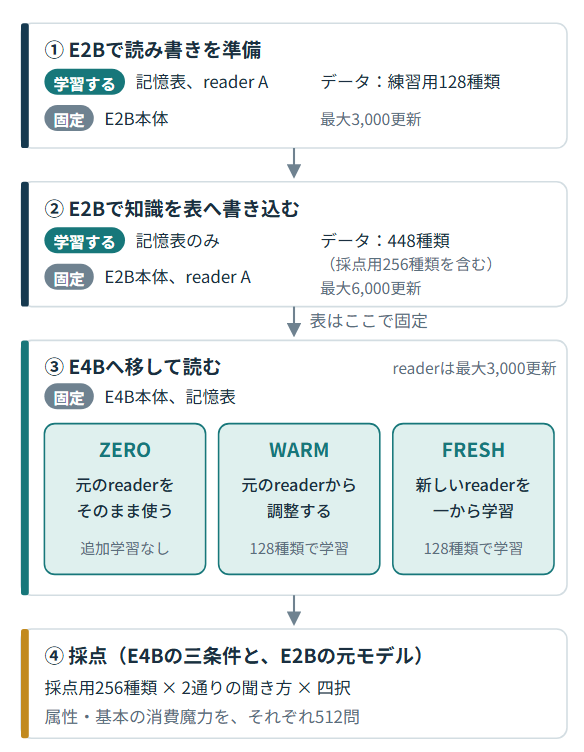
モデル本体の重みは凍結し、追加した記憶領域・表とreaderだけを学習する。今回の表は約4.2Mパラメータ、readerは約0.33Mパラメータである。学習は前回と同じく三段階に分けた。
| 段階 | 学習するもの | 固定するもの | 使うデータ |
|---|---|---|---|
| ① E2Bモデルで読み書きを準備 | 記憶領域・表、reader A | E2B本体 | 練習用128種類 |
| ② 知識を記憶領域へ書き込む | 記憶領域・表のみ | E2B本体、reader A | 448種類。採点用256種類も含む |
| ③ E4Bモデルで読み方を調整 | readerのみ | E4B本体、記憶領域・表 | 練習用128種類のみ |
②ではreaderを固定し採点用の答えを表以外に覚えさせていない。採点用の情報は元の表のみに影響させ、記憶を介して使えるかを検証する。③も次の3通りに分けている。
| 条件 | 移植先のreaderをどうするか |
|---|---|
| ZERO:そのまま移す | 元のreaderを固定して使う。移植先での追加学習なし |
| WARM:元の読み方を調整する | 元のreaderから始め、練習用128種類で追加学習 |
| FRESH:新しく読み方を学ぶ | readerを新しく作り、同じ128種類で学習 |
採点では四つの回答候補の尤度を比べ、最も高い候補を予測とする。属性は0=火、1=水、2=風、3=土、消費魔力は1〜4を候補とした。採点用256種類に2通りの聞き方を使うため、各列の分母は512問である。正解は各候補128問ずつなので、ランダムに答えても、同じ候補を答え続けても、期待正答率は25%になる。
実験はColab上のNVIDIA RTX PRO 6000 Blackwell Server Editionで行った。本体はBF16、表とreaderはFP32である。学習時には8例分をためてパラメータを更新した。early stoppingを有効にし全体の計算時間は約12時間である。
結果
結果概要は下記の通りである。Gemma 3n + engramは有効そうである。記憶の移植も前回より良い性能でできている。ただ、マトリョーシカ構造であってもreaderもそのまま移植するのは難しそうに見える。
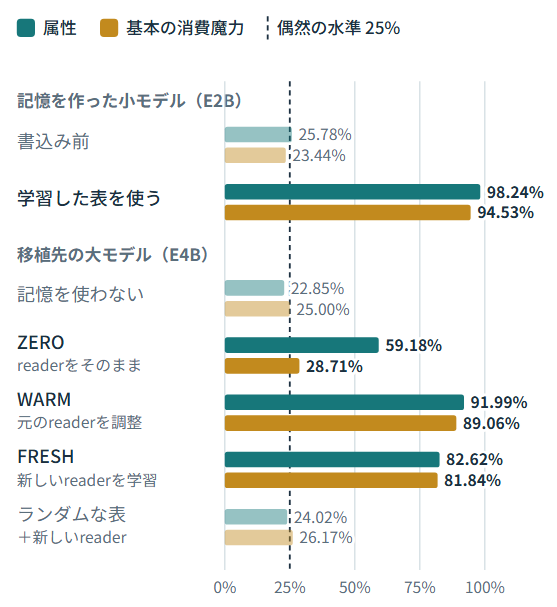
1. LLM+Engramで記憶できるか? → 属性も消費魔力も9割以上
| 元モデル(E2B)の状態 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| 採点用の事実を書き込む前 | 25.78% | 23.44% |
| 書込み後、学習した表を使う | 98.24% | 94.53% |
| 書込み後、記憶を使わない | 27.73% | 24.02% |
事実を書き込む前や、記憶を使わない場合はほぼランダムな結果である。学習した表を使うと、属性・消費魔力とも9割超と、記憶を作ったE2Bモデルは記憶を有効に使えていそうである。
2. 記憶と読み方をそのまま移せるか? → 属性のみ一部移せた。調整すれば両方有効になる。
| 移植先(E4B)の条件 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| 記憶を使わない | 22.85% | 25.00% |
| そのまま接続:ZERO | 59.18% | 28.71% |
| 元のreaderを調整:WARM | 91.99% | 89.06% |
| 新しいreaderを学習:FRESH | 82.62% | 81.84% |
| ランダムな表+新しいreader | 24.02% | 26.17% |
| 並べ替えた表+新しいreader | 24.80% | 26.37% |
ZERO(記憶表も記憶を読み取る部品であるreaderもそのまま移植)は属性59.18%で、記憶なしの22.85%を上回る。一方、消費魔力は28.71%とランダムに近い。マトリョーシカ構造の大小モデルであってもreaderの調整なしに記憶が使えるわけではなさそうである。
WARM、FRESHというreaderを調整する条件ではE2Bで記憶した内容を有効に使えていることが分かる。ただし、元の性能を完全に保てているわけではない。
3. スコアが落ちた理由は?
スコアが落ちた原因を調べるため追加的な検証を行った。まず、E2Bモデルを用いて、readerだけを新しくし練習用128種類で学習し直すと正解率は属性77.15%、消費魔力72.46%だった。記憶の利用においてはreaderの果たす役割が大きいことが分かる。また、FRESHでの比較、E2B(77.15%、72.46%)とE4B(82.62%、81.84%)の差は128例でreaderを学ぶことの限界を示唆しているように思う。
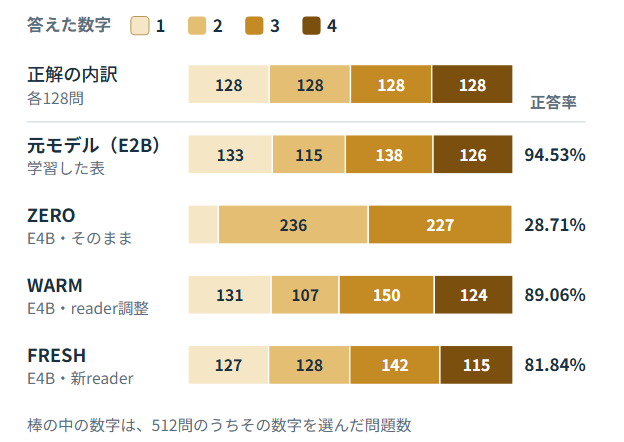
次にZEROで正解率の低かった消費魔力についてモデル出力を検証した。すると、そのまま接続したZEROだけは、512問中236問で「2」、227問で「3」を選ぶなど回答に大きな偏りが出ていた。さらに、間違えた365問のうち255問では、選んだ誤答に9割以上の確率を付けるなど謎の挙動をしている。前回の結果でも示唆されていたが、属性と魔力値でモデル内の扱いが異なっていそうに見える。例えば、消費魔力が数値として扱われ順序ある軸上に表現されたと仮定すると、中間値の「2」「3」によるのは一定理解できる。実際そうなっているかはっきりしないことに注意が必要だが、とても興味深い。
所感
Engram型の記憶を、マトリョーシカ構造のGemma 3nで移植してみた。共通の親から作った大小モデルでも、そのまま記憶を移植することは難しかった。属性の一部は使えたが、消費魔力はほぼ読めなかった。一方で別の魔法の情報を使い、読み方を少し練習するだけでスコアが大きく上がった。前回のQwen3.5との比較だけでは何とも言えないが、他のモデルも幅広く試すとマトリョーシカ構造の効果なのか、単にモデル性能の差なのかなどがはっきりしそうである。
また、前回の結果でも示唆されていたが、属性と魔力値の学習経過が異なるように見える[6]。モデル中で数値(順序関係のあるもの、あるいは、加算など数学的扱いが可能な形式言語)と自然言語の扱いが異なるとかだと非常に面白いと思う。うまく実験設計して差を見てみたい。
この実験で小モデルの記憶を大モデルに移植することはいったん見込みが立った[7]。次は、小モデルが分担して覚えた記憶を一つにまとめ、大モデルで使えるかを試してみた。分身が持ち帰った敵の情報を本体が学習する、ありがちだが熱い展開である。
脚注
[1] LLM構築ではなくembeddingを対象とした論文だが考え方はAditya Kusupati, et al, “Matryoshka Representation Learning,” 2024.(https://arxiv.org/abs/2205.13147)が早期に出ている。
[2] Google, “Gemma 3n model overview,” 「Model parameters and effective parameters」「MatFormer architecture」節、およびGoogleのGemma 3n E4B-itモデルカード。
[3] Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. (https://arxiv.org/abs/2601.07372)のEngramを参考に記憶領域をGemma3nに組み込み、Mingyuan Li, et al, “Frozen Memory Is Not Enough: Rethinking External Memory as Extraction,” 2026.(https://arxiv.org/abs/2608.17050)と同様、記憶領域の移植を試している。
※前回の記事時点からバージョンアップがあり、2608.17050の題名が変わっていた。
[4] 微妙な結果とはいえ一定使えているのは興味深い。
[5] Devvrit, et al, “MatFormer: Nested Transformer for Elastic Inference,” 2024.(https://arxiv.org/abs/2310.07707)
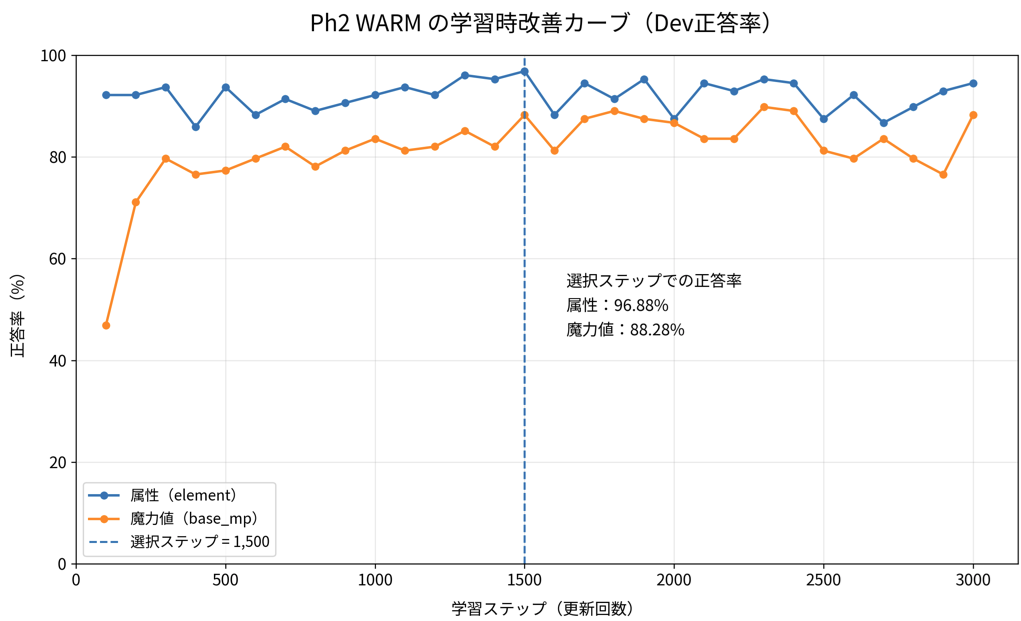
[6] 学習曲線は下記の通り。両者の性能が異なるのは偶然なのか、何らか面白い理由があるのかに興味津々。
[7] ことにする。
「Matryoshka構造のGemma3n + Engramだと記憶は移植しやすい(?)」への1件のフィードバック