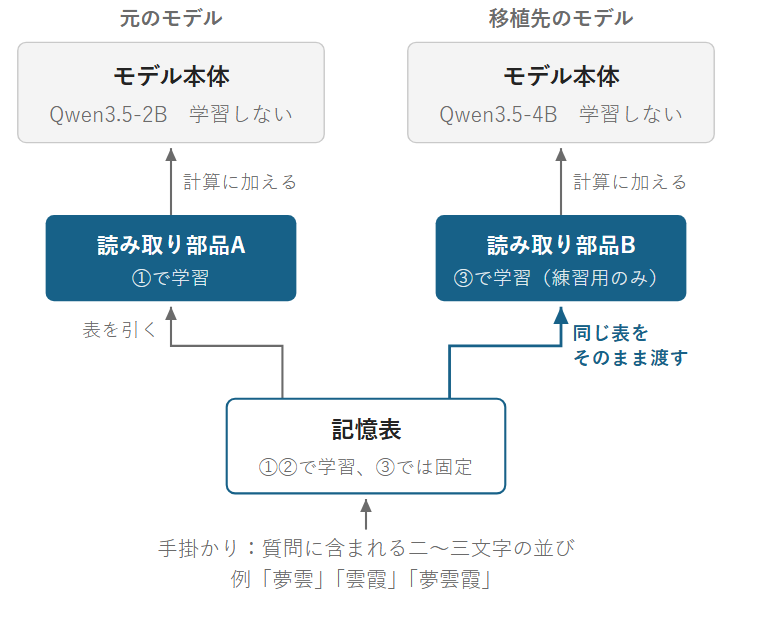
複数の小規模AIが覚えた記憶(Engram)を、大規模AIがまとめて使う

分身して戦い、負けて消えた分身の記憶を本体が受け取り強くなる。アニメや漫画ではおなじみの展開である。AIで同じことをやってみた[1]。

前の記事では、マトリョーシカ構造のGemma 3nで、小さいモデルが作った記憶を大きいモデルへ移植し一定の効果が確認できた。今回は複数の小さいモデルが分担して作った記憶を、一つにまとめて大きいモデルで使えるか実験した[2]。結果、記憶を統合することも一定できそうで、うまく統合すると8割正解できる。一方で統合せずに二つの表を正しく使い分けた場合(属性約89%、消費魔力約82%)には届かなかった。

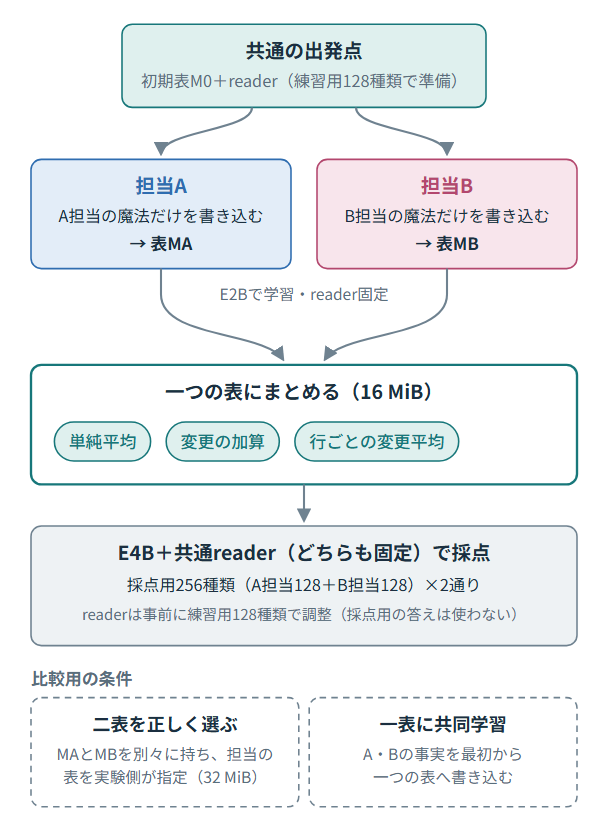
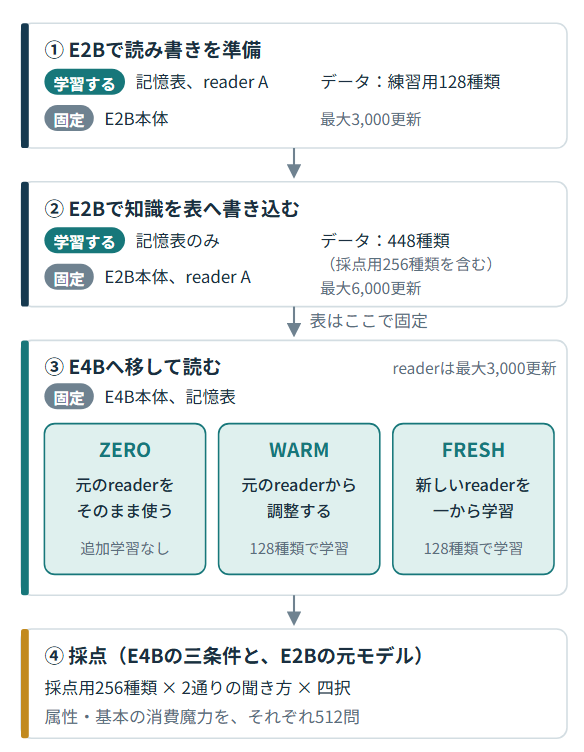
今回の実験では追加したEngram型の記憶領域・表だけを別々に学習してマージしている。実験の流れは下図の通り。表のマージ方針で差異が出ているのが興味深い[3]。
モデルに記憶させるもの

基本的な構成は前回同様である。記憶する魔導書は「ルドラの秘宝」の言霊から着想を得た実験用のものである。三文字の魔法名を根底語とし、「火・水・風・土」の属性と、1から4までの基本の消費魔力を割り当てている。小モデルはGemma 3nのE2B構成、大モデルはE4Bと前回同様である。同じ親から大小を作り、どちらも本体のweightを凍結している。読み方の練習用128種類は共通、途中確認用と採点用をAとBで半分ずつ分担した。
※ 採点用の知識は分担、AとBで異なるが練習用データには重複がある。

データAの担当Bの担当
読み方の練習用共通の128種類Aと同じ128種類
途中確認用32種類Aとは別の32種類
採点用128種類Aとは別の128種類
書き込む種類の合計288種類288種類

手法

記憶の移植先であるE4Bでは、共通初期状態のreaderを基に、練習用128種類とA/Bの表で読み方を調整した。その後はreaderを固定し、表だけを差し替えて評価する。採点用256種類の答えは、readerの学習には使っていない。

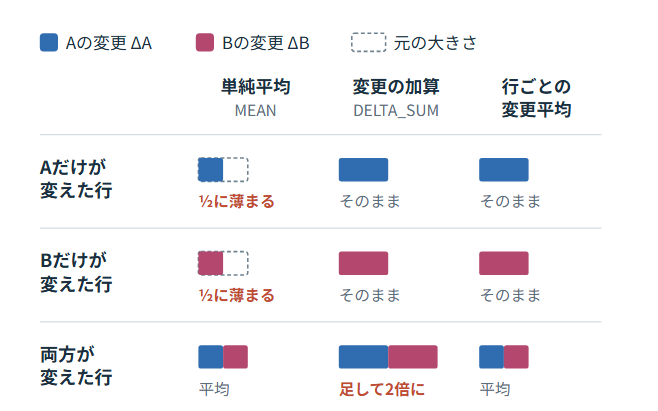
共通の初期表をM0、AとBが作った表をMA、MBとする。M0からの変更分を、それぞれΔA=MA−M0、ΔB=MB−M0として下記の3パターンを試した。「M0+α × (ΔA+ΔB)」を考えると、単純平均はα=1/2、変更の加算はα=1、行ごとの変更平均は「その行を変えた担当の数」で割ったものである。

方法実施すること
単純平均MAとMBの値を平均する
変更の加算初期表M0に、Aの変更ΔAとBの変更ΔBを両方足す
行ごとの変更平均片方だけが変えた行はその変更を残し、両方が変えた行では変更を平均する

比較として下記パターンも検証している。

方法実施すること
二表を正しく選ぶA/Bの表を別々に持ち、問題の魔法を担当した方の表を実験側で指定
一表に共同学習A/Bの事実を最初から一つの表へ書く

今回もGoogle Colab上のRTX PRO 6000 Blackwell Server Edition 1枚で実験を行っている。比較対照・統合後の評価まで含めて約6時間かかった。

結果

結果は下図の通りで、表のマージは一定可能そうに見える。
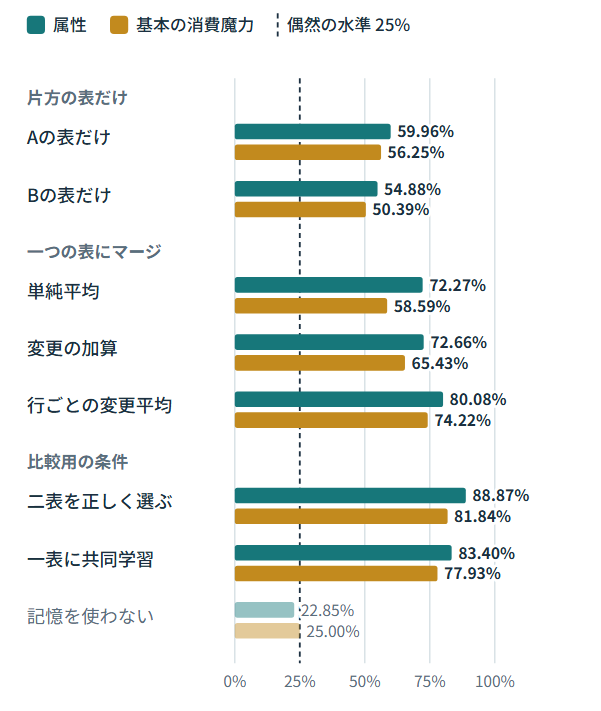
1. 小さいモデルの複数の記憶を大きなモデルで使えるか? → 属性も消費魔力も使える

渡した記憶・情報属性の正答率基本の消費魔力の正答率
Aの表だけ59.96%56.25%
Bの表だけ54.88%50.39%
二表を正しく選ぶ88.87%81.84%
一表に共同学習83.40%77.93%
記憶を使わない22.85%25.00%

AかBの表だけでは属性・消費魔力とも正解率は6割弱だが、正しい担当の表を使うと属性88.87%、消費魔力81.84%となる。大モデルが、分担して作った両方の記憶を利用できている。
属性88.87%、消費魔力81.84%というスコアは正しい表を実験側で与えた結果であることに注意が必要なものの、一表に共同学習している結果を上回るのは意外である[4]。

2. 一つの記憶領域・表にマージしても使えるか? → 使えるが、方法によって差がある

マージ方法属性の正答率基本の消費魔力の正答率
単純平均72.27%58.59%
変更の加算72.66%65.43%
行ごとの変更平均80.08%74.22%
参考:二表を正しく選ぶ88.87%81.84%

3パターンのマージ方式では、行ごとの変更平均のスコアが高かった。ただし、二表を正しく選ぶ場合からは、属性で8.79ポイント、消費魔力で7.62ポイント低く完璧に統合できてはいない。

3. 片方の記憶だけを使っていないか? → 両方の記憶が使える

結果を、担当する魔法ごとに分けると下記のようになる。片方の表だけでは、担当外の正答率はランダムと同じ25%前後になる。分担した魔導書を集約する狙いに沿った結果になった。

一方、消費魔力では担当による違いが目立つ。Aの表はA担当の消費魔力を92.58%正解するが、行ごとの変更平均では75.00%まで下がった。B担当は、もともとBの表で71.09%で、統合後も73.44%とほぼ変わらない。前回同様、属性と魔力で動作が異なっているのが興味深い。

条件A担当・属性B担当・属性A担当・消費魔力B担当・消費魔力
Aの表だけ92.19%27.73%92.58%19.92%
Bの表だけ24.22%85.55%29.69%71.09%
二表を正しく選ぶ92.19%85.55%92.58%71.09%
単純平均76.95%67.58%59.77%57.42%
変更の加算76.17%69.14%68.75%62.11%
行ごとの変更平均82.42%77.73%75.00%73.44%

4. 統合でどれくらいの記憶を失ったか? → 変化した回答は多く、自信を持って間違える

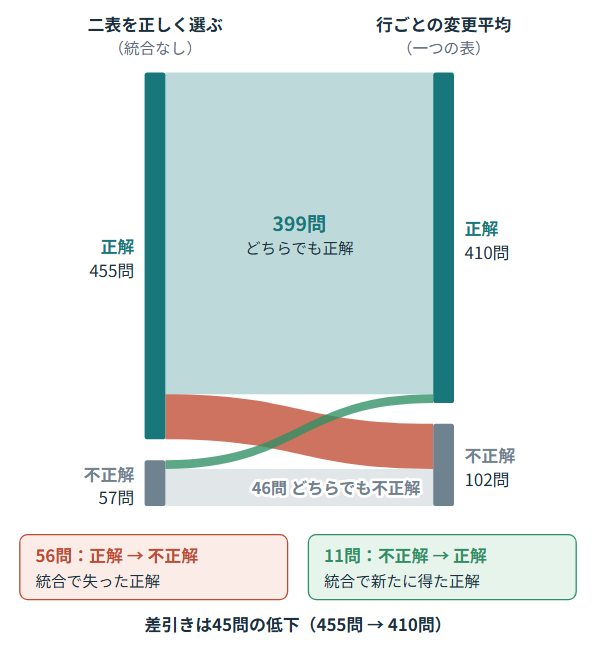
行ごとの変更平均は、属性で二表を正しく選ぶ場合より8.79ポイント低い。正解数は455問から410問へ減少している。問題別に分析すると下記のようになる。

二表選択から一表統合への変化属性の問題数
正解 → 正解399
正解 → 不正解56
不正解 → 正解11
不正解 → 不正解46

行ごとの変更平均で消費魔力を間違えた132問のうち、105問では、誤った答えに9割以上の確率を付けていた。統合で失われた知識について「自信がない」とはならず、自信を持って間違えている。これは前回も見られた傾向である。

記憶の仕方に関する分析

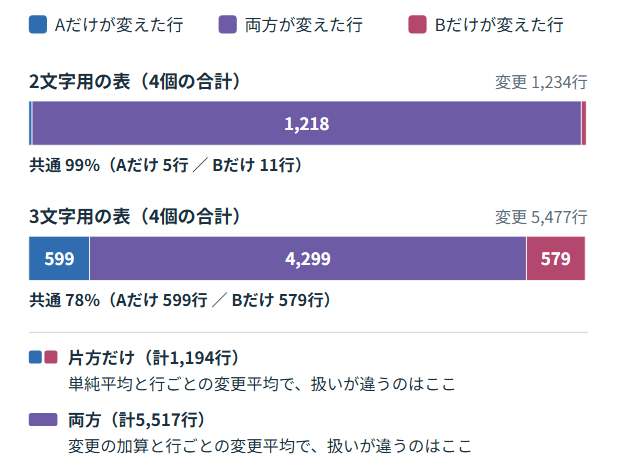
今回の記憶では質問文の2〜3文字の並びから複数の行を参照するアーキテクチャを用いており、違う魔法でも同じ場所を使うことがある。AとBが変えた領域は下図のようになった。どちらかが変えた部分を丁寧に扱うのに効果があるのはそうだと思いつつ、練習用の128種類が影響しているのか、衝突している領域が意外と多かった。
所感

「分身が別々に覚えた記憶を本体へ集める」という展開を小さな規模で試行、それっぽい結果にはなった[5]。

前回を含めてだが、Aの魔法とBの魔法の消費魔力を足す、といった問題は実施しておらず、記憶を組み合わせた推論や計算などより高度な処理に使えるのか?という疑問はある。このあたりはぜひ検証してみたいところである。

改めてEngramはモデルに組み込みやすく効果が出やすい面白い手法だと思う。外部メモリ関連はなかなか実用に足るものが出てきていなかったが、今後このあたりの研究が進むと良いなと思う。

最近の検証はGPT-6 AstraをChatGPTとCodexから使って実施、同じ環境+Claude(Opus 5.5)で分析などを行っている。アイデアから実験、分析までとても素早くできる時代になって改めて技術の進化を感じる。

脚注

[1] 先行研究は多くある。Peng Wang et al. “WISE: Rethinking the Knowledge Memory for Lifelong Model Editing of Large Language Models.” Advances in Neural Information Processing Systems, 37, 2024.(https://arxiv.org/abs/2405.14768)、Ryan Wei Heng Quek, et al., “MeMo: Memory as a Model,” 2026.(https://arxiv.org/abs/2605.15156)など。いずれも複数の記憶(編集差分や記憶モデル)の統合を扱うが、WISEはFFN部分を利用、MeMoは記憶モデルへの問い合わせであり、今回のEngram型記憶表の統合とは、記憶の形式と読み出し方が異なる。
[2] 実験設定は前回とほぼ同じである。Google, “Gemma 3n model overview,” に Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. (https://arxiv.org/abs/2601.07372)のEngramを参考にした記憶領域を組み込み、Mingyuan Li, et al, “Frozen Memory Is Not Enough: Rethinking External Memory as Extraction,” 2026.(https://arxiv.org/abs/2608.17050)と近い手法で記憶領域の移植を試している。
[3] 単純平均でもそこそこのスコアが出せている点は面白いが、モデルマージでも近しい動きがあったりするのでそういうものなんだろうと思わなくはない。また、前回同様、属性よりも魔力の方がスコアが低いのは深堀ポイントな気はしている。
[4] 記憶領域が足りていないのかなという気もしないではない。
[5] そもそもログなり軌跡(trajectory)なりを集めて学習したほうが効果が高く、Memoryだけ抜き出す意味はないのでは?というツッコミはしてはいけない。もちろん、通信量の削減や連合学習的な良さなどあるにはあるが。。。
Matryoshka構造のGemma3n + Engramだと記憶は移植しやすい(?)

前の記事では、Qwen3.5 2Bに架空の魔導書を記憶させ、その記憶をQwen3.5 4Bで使えるか試した。結果、一部は使えていそうだが、移植元と移植先で大きな性能差があった。今回は大小のモデルが重みを共有していたら記憶の移植がしやすいのでは?という仮説に基づき、マトリョーシカ構造[1]のGemma 3n [2]を用いて前回同様の実験[3]を行った。

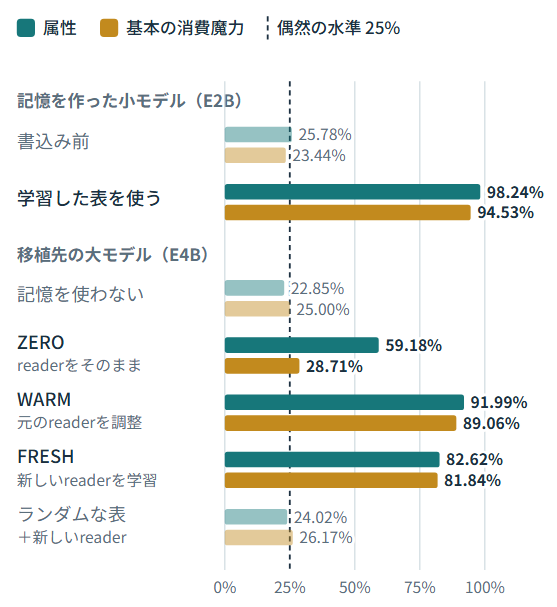
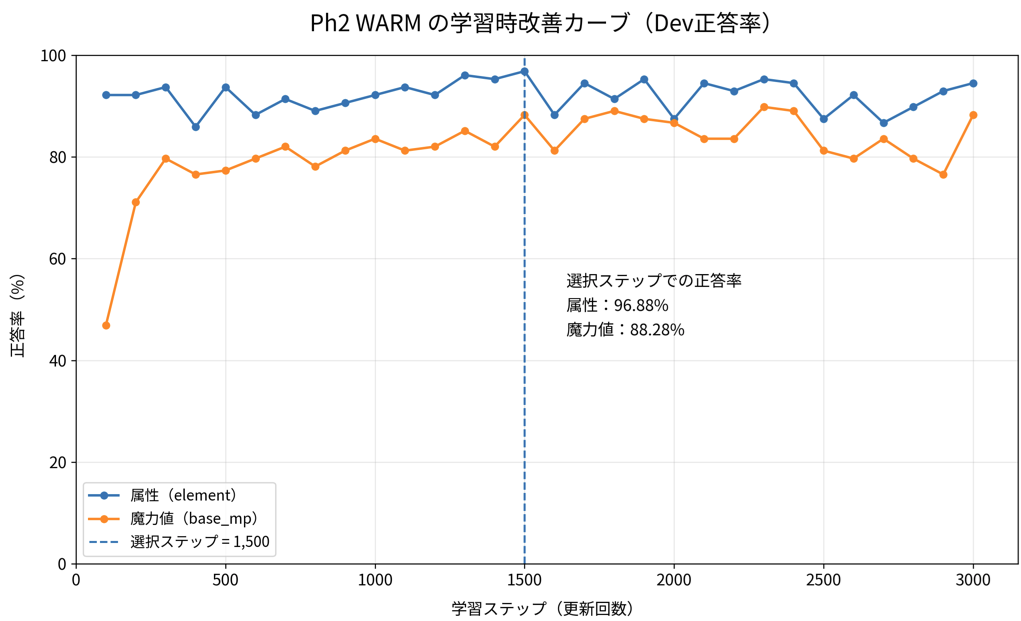
結果、移植元のモデルは属性98.24%、基本の消費魔力94.53%を正解、移植後のモデルで読み方を調整すると91.99%、89.06%正解した。移植元と移植先で差異はあるものの前回より大きく改善している。なお、読み方を調整せずそのまま接続すると59.18%、28.71%で課題が残った[4]。

ベースモデルの構造・マトリョーシカ構造

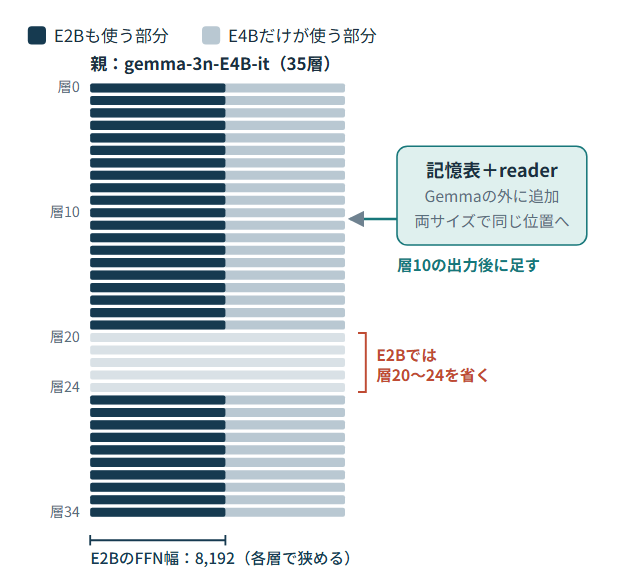
マトリョーシカ構造は大きなモデルの中に小さなモデルが内包され、マトリョーシカ人形のような構造をしている。Gemma 3nはMatFormer[5]を利用しており、大きいE4Bの中に、小さいE2Bのパラメータを含んでいる。今回はgoogle/gemma-3n-E4B-itを親として、E2B構成を切り出して使った(下図参照)。このようなアーキテクチャを用いることでE2B→E4Bの知識移植が効率的に行えないかを検証する。

モデルに記憶させるもの

基本的な構成は前回同様である。記憶する魔導書は「ルドラの秘宝」の言霊から着想を得た実験用のものである。三文字の魔法名を根底語とし、「火・水・風・土」の属性と、1から4までの基本の消費魔力を割り当てている。全512種類を、練習用128種類、途中確認用64種類、採点用256種類、(未登録64種類)に分けた。今回は基本情報を直接尋ねる問題に絞っている。前回と異なり魔導書の差し替えや英語での質問は評価していない。

手法

モデル本体の重みは凍結し、追加した記憶領域・表とreaderだけを学習する。今回の表は約4.2Mパラメータ、readerは約0.33Mパラメータである。学習は前回と同じく三段階に分けた。

段階学習するもの固定するもの使うデータ
① E2Bモデルで読み書きを準備記憶領域・表、reader AE2B本体練習用128種類
② 知識を記憶領域へ書き込む記憶領域・表のみE2B本体、reader A448種類。採点用256種類も含む
③ E4Bモデルで読み方を調整readerのみE4B本体、記憶領域・表練習用128種類のみ

②ではreaderを固定し採点用の答えを表以外に覚えさせていない。採点用の情報は元の表のみに影響させ、記憶を介して使えるかを検証する。③も次の3通りに分けている。

条件移植先のreaderをどうするか
ZERO:そのまま移す元のreaderを固定して使う。移植先での追加学習なし
WARM:元の読み方を調整する元のreaderから始め、練習用128種類で追加学習
FRESH:新しく読み方を学ぶreaderを新しく作り、同じ128種類で学習

採点では四つの回答候補の尤度を比べ、最も高い候補を予測とする。属性は0=火、1=水、2=風、3=土、消費魔力は1〜4を候補とした。採点用256種類に2通りの聞き方を使うため、各列の分母は512問である。正解は各候補128問ずつなので、ランダムに答えても、同じ候補を答え続けても、期待正答率は25%になる。

実験はColab上のNVIDIA RTX PRO 6000 Blackwell Server Editionで行った。本体はBF16、表とreaderはFP32である。学習時には8例分をためてパラメータを更新した。early stoppingを有効にし全体の計算時間は約12時間である。

結果

結果概要は下記の通りである。Gemma 3n + engramは有効そうである。記憶の移植も前回より良い性能でできている。ただ、マトリョーシカ構造であってもreaderもそのまま移植するのは難しそうに見える。

1. LLM+Engramで記憶できるか? → 属性も消費魔力も9割以上

元モデル(E2B)の状態属性の正答率基本の消費魔力の正答率
採点用の事実を書き込む前25.78%23.44%
書込み後、学習した表を使う98.24%94.53%
書込み後、記憶を使わない27.73%24.02%

事実を書き込む前や、記憶を使わない場合はほぼランダムな結果である。学習した表を使うと、属性・消費魔力とも9割超と、記憶を作ったE2Bモデルは記憶を有効に使えていそうである。

2. 記憶と読み方をそのまま移せるか? → 属性のみ一部移せた。調整すれば両方有効になる。

移植先(E4B)の条件属性の正答率基本の消費魔力の正答率
記憶を使わない22.85%25.00%
そのまま接続:ZERO59.18%28.71%
元のreaderを調整:WARM91.99%89.06%
新しいreaderを学習:FRESH82.62%81.84%
ランダムな表+新しいreader24.02%26.17%
並べ替えた表+新しいreader24.80%26.37%

ZERO(記憶表も記憶を読み取る部品であるreaderもそのまま移植)は属性59.18%で、記憶なしの22.85%を上回る。一方、消費魔力は28.71%とランダムに近い。マトリョーシカ構造の大小モデルであってもreaderの調整なしに記憶が使えるわけではなさそうである。

WARM、FRESHというreaderを調整する条件ではE2Bで記憶した内容を有効に使えていることが分かる。ただし、元の性能を完全に保てているわけではない。

3. スコアが落ちた理由は?

スコアが落ちた原因を調べるため追加的な検証を行った。まず、E2Bモデルを用いて、readerだけを新しくし練習用128種類で学習し直すと正解率は属性77.15%、消費魔力72.46%だった。記憶の利用においてはreaderの果たす役割が大きいことが分かる。また、FRESHでの比較、E2B(77.15%、72.46%)とE4B(82.62%、81.84%)の差は128例でreaderを学ぶことの限界を示唆しているように思う。

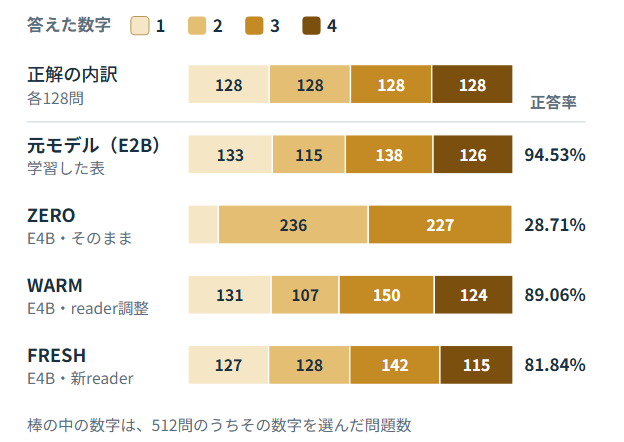
次にZEROで正解率の低かった消費魔力についてモデル出力を検証した。すると、そのまま接続したZEROだけは、512問中236問で「2」、227問で「3」を選ぶなど回答に大きな偏りが出ていた。さらに、間違えた365問のうち255問では、選んだ誤答に9割以上の確率を付けるなど謎の挙動をしている。前回の結果でも示唆されていたが、属性と魔力値でモデル内の扱いが異なっていそうに見える。例えば、消費魔力が数値として扱われ順序ある軸上に表現されたと仮定すると、中間値の「2」「3」によるのは一定理解できる。実際そうなっているかはっきりしないことに注意が必要だが、とても興味深い。

所感

Engram型の記憶を、マトリョーシカ構造のGemma 3nで移植してみた。共通の親から作った大小モデルでも、そのまま記憶を移植することは難しかった。属性の一部は使えたが、消費魔力はほぼ読めなかった。一方で別の魔法の情報を使い、読み方を少し練習するだけでスコアが大きく上がった。前回のQwen3.5との比較だけでは何とも言えないが、他のモデルも幅広く試すとマトリョーシカ構造の効果なのか、単にモデル性能の差なのかなどがはっきりしそうである。

また、前回の結果でも示唆されていたが、属性と魔力値の学習経過が異なるように見える[6]。モデル中で数値(順序関係のあるもの、あるいは、加算など数学的扱いが可能な形式言語)と自然言語の扱いが異なるとかだと非常に面白いと思う。うまく実験設計して差を見てみたい。

この実験で小モデルの記憶を大モデルに移植することはいったん見込みが立った[7]。次は、小モデルが分担して覚えた記憶を一つにまとめ、大モデルで使えるかを試してみた。分身が持ち帰った敵の情報を本体が学習する、ありがちだが熱い展開である。

脚注

[1] LLM構築ではなくembeddingを対象とした論文だが考え方はAditya Kusupati, et al, “Matryoshka Representation Learning,” 2024.(https://arxiv.org/abs/2205.13147)が早期に出ている。
[2] Google, “Gemma 3n model overview,” 「Model parameters and effective parameters」「MatFormer architecture」節、およびGoogleのGemma 3n E4B-itモデルカード。
[3]  Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. (https://arxiv.org/abs/2601.07372)のEngramを参考に記憶領域をGemma3nに組み込み、Mingyuan Li, et al, “Frozen Memory Is Not Enough: Rethinking External Memory as Extraction,” 2026.(https://arxiv.org/abs/2608.17050)と同様、記憶領域の移植を試している。
※前回の記事時点からバージョンアップがあり、2608.17050の題名が変わっていた。
[4] 微妙な結果とはいえ一定使えているのは興味深い。
[5] Devvrit, et al, “MatFormer: Nested Transformer for Elastic Inference,” 2024.(https://arxiv.org/abs/2310.07707)
[6] 学習曲線は下記の通り。両者の性能が異なるのは偶然なのか、何らか面白い理由があるのかに興味津々。

[7] ことにする。

LLMに情報を記憶(Engram)し別モデルへ移植

前の記事では、小型の言語モデルをPost trainingし敬語変換機能を強化した。今回は少し方向を変え、記憶[1]に着目した実験を行った。LLM(Qwen/Qwen3.5-2B-Base[2])に架空の魔導書を記憶させ、その記憶を別のLLM(Qwen/Qwen3.5-4B-Base)で使えるか試してみた。

言語モデルに「記憶領域」を組み合わせるEngram(エングラム)[3]というアーキテクチャがある。短い言葉の並びを用いて学習済みの記憶領域から必要な情報を取り出し推論時に使うもので、人でいうところの記憶のような動作をする。最新のLLMであるQwen3.8-Flash-Next(N-gram Embedding)やDeepSeek-V4.1-Flash(Engram)でも取り入れられている[4][5]。また、記憶を別のモデルへ移す研究「Cross-Model Memory Transfer via Target-Side Reader Adaptation」も発表されている[6]。これは、あるモデルで作った記憶領域を別のモデルにつなぐものである。

本実験では日本語で作った架空の魔導書を使い、Qwen3.5の2Bモデルで作った記憶領域を、4Bモデルへ移してみた。Qwen3.5に追加した記憶領域はEngramを参考に独自に実装しており公式の実装ではない。

まず、4択問題で元のモデルは魔法の属性を95%、基本の消費魔力を96%正解した。これは追加したEngram型の構造により情報を記憶できていることを示唆している。次に学習した記憶を別のモデルに渡した。記憶を渡されたモデルは魔法の属性を55%、基本の消費魔力を67%の正答率で答えた。でたらめな記憶を使った場合は約25%で、四択をてきとーに答えたときと変わらない。学習した記憶は別のモデルでも(一部)使えていた。なお、記憶を差し替えると、変えなくてよい答えまで変化した。このあたりの動きもとても面白い。

記憶させる魔導書について

LLMに記憶させる情報は今まで世の中にはないものが望ましい。そのため、以前はまったプレイヤーが「言霊」と呼ばれる魔法を作れるゲーム、「ルドラの秘宝」[7]の雰囲気で架空の魔法を覚えさせることにした。(名前も設定も今回の実験用に新たに作っている)

三文字の名前を持つ512種類の魔法に、「火・水・風・土」のいずれかの属性と、1から4までの基本の消費魔力を割り当てた。例えば、次のような内容である。

魔法の名前属性基本の消費魔力
月雲霧土3
霞影夢水2
夢雲霞土1

モデルには「夢雲霞の属性は何か」「基本の消費魔力はいくつか」と質問する。前者は土、後者は1が正解になる。名前と性質は意図的に切り離している。「雲」という字があるから風属性、というようには推測できない。加えて、名前の頭に「強」を付けると、属性はそのままで消費魔力が2増える、「転」とつけると属性を次へ変更・消費魔力+1といったルールも用意した[8](が時間の都合上、一部使えなかった設定がある)。

手法

今回使うのは、Qwen3.5に独自の「記憶領域」と「読み取り部品」を追加したモデルである。記憶領域の実体は、質問に含まれる二〜三文字の並び(「夢雲」「雲霞」「夢雲霞」など)を手掛かりに、該当する行の数値を引く表である。読み取り部品は、引いた数値をモデル本体の計算に加えるためのものである。モデル本体のweightは凍結している。追加した記憶領域は約4Mパラメータ、読み取り部品は約0.4Mパラメータである。

学習は三段階に分けた。

段階学習するもの固定するもの使うデータ
① 元のモデルで学習する記憶領域・表
読み取り部品A
元のモデル本体(2B)練習用の128種類
② 知識を記憶領域に書き込む記憶領域・表元のモデル本体
読み取り部品A
448種類
(採点用の256種類を含む)
③ 移植先で読み方を調整する読み取り部品B移植先の本体(4B)
記憶領域・表
練習用の128種類のみ

②で読み取り部品を固定するのは、新しい答えを記憶領域・表以外に覚えさせないためである。③のとおり、移植先でも読み取り部品は学習している。「記憶を渡しただけで、何の調整もせず答えられた」というわけではないことに注意してほしい(とはいえ、③で採点用256種類の答えを使っていないなど変な学習が起きないよう気は使っている)。評価時には4択で答えさせておりランダムだと25%の正解率となる[9]。

比較用として、ランダムな記憶領域・表、記憶を使わない場合を用意した。ランダムな記憶領域・表を使う場合でも、学習した記憶領域・表と同じ条件で読み取り部品を学習させている。これは読み取り部品を学習させただけではスコアが上がらない確認のためである。また、魔導書の差し替え、英語での質問も試してみた。

学習では16例分をためて更新、それぞれの更新回数は2Bが基本1000回、4Bが基本3000回とした(学習対象によって一定しない)。学習にはNVIDIA RTX PRO 6000を用い、①~③の処理に約4時間30分かかった。

結果

① LLM + Engramで知識を記憶できるか? → 記憶できる

Engram型の記憶領域を組み込んだQwen3.5 2Bモデル(元モデル)は魔法の属性を95%、基本の消費魔力を96%正解した。Engram型の記憶領域を作ることで情報の記憶ができ、高い正答率で読み出せたと解釈できる。

64種類で評価属性の正答率基本の消費魔力の正答率
元のモデル(2B、記憶領域・表を作った側)95%96%

② 記憶した内容は別のモデルでも使えるか? → ある程度使える

日本語の名前を使い、日本語で質問した結果は下表の通り。記憶領域・表を渡すことでスコアが向上しているのが分かる。

渡した記憶・情報属性の正答率基本の消費魔力の正答率
学習した記憶領域・表55%67%
ランダムな記憶領域・表24%25%
記憶を使わない25%25%

一方で記憶領域・表を作った元のモデル自身の成績とはかなり差がある。

64種類で評価属性の正答率基本の消費魔力の正答率
元のモデル(2B、記憶表を作った側)95%96%
移植先のモデル(4B)59%65%

記憶領域・表への書き込みはおおむねできていて、別のモデルで読み出すところで取りこぼしていそうな結果である[10]。

③ 記憶領域を差し替えると答えも変わるか → 変わるが間違いも

次に、属性だけを変えた二冊目の魔導書に差し替えた[11]。二冊目では、採点用256種類すべての属性を「火→水→風→土→火」の順に一つずつずらしている。「夢雲霞」なら土から火に変わり、消費魔力は1のままである。本体と読み取り部品、質問文はそのままで、「別の世界になった」といった説明も加えていない。

面白いことに「夢雲霞」では、二通りの聞き方のどちらでも、正解どおりに答えが切り替わった。

「夢雲霞」の正解と回答最初の魔導書差し替え後
属性土火
基本の消費魔力11

交換の前後どちらでも正しい属性を答えられたのは3割程度。記憶領域を差し替えることで回答を変えられた事例はあるものの正直安定はしていない。

確認すること条件を満たした組数
属性が交換の前後とも正しい167/512組(33%)
消費魔力が、前後とも正しい262/512組(51%)
属性の切り替えと消費魔力の保持を同時に満たす
※「夢雲霞」のような事例
79/512組(15%)

④ 別の言語で記憶を使えるか? → 手がかりとなる情報に依存

日本語で記憶した知識を英語でも使えるか確認した。結果、名前が日本語のままなら、英語で質問しても属性の正答率は落ちなかった。英語名ではほぼランダムな結果だが、答えを含まない対応表を用意することで一部は回復した。

質問と名前の条件属性の正答率基本の消費魔力の正答率
日本語の質問・日本語名55%67%
英語の質問・日本語名59%40%
英語の質問・英語の別名27%25%
英語の別名から、日本語名の記憶へ案内する45%31%

英語の質問・日本語名の場合、属性は約4ポイント高いが、消費魔力は約27ポイント低い。属性部分の若干の性能向上、属性と消費魔力の差が言語差異によるものなのかは不明だが、とても興味深い結果である。

所感

Engramによる記憶領域の追加と記憶が他のモデルに移せるかを実験してみた。ある程度は効果がありそうでとても興味深い。

現状、新たな知識をAIに使わせる場合はRAGを使用することが多い。GraphRAG、Agentic RAG、その後のAgenticな動作のAI Memoryを含めて記憶部分をコンテキストに入れる設計は変わっていない[12]。EngramはLLM本体のweightとコンテキストの中間に位置するように見え、うまく使えるとLLMの使い勝手が向上しそうである。

この検証はGPT-6 AstraをChatGPTとCodexから使って実施したが、思い付きを実装するのが本当に楽になった。実装確認や結果確認が必須とはいえ、すごい時代になったものだと思う。

脚注

[1] LLMにおいてスキルと記憶は異なるのでは?という研究は昔からある。Knowledge Editingという分野もある。
[2] Qwen/Qwen3.5-2B-Base · Hugging Face, Qwen/Qwen3.5-4B-Base · Hugging Face、いずれもApache-2.0 ライセンス。
[3] Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. https://arxiv.org/abs/2601.07372
[4] Zihan Qiu, et al, “On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability,” 2026. https://arxiv.org/abs/2608.30320、N-gram Embeddingという名称でEngramと近い構造を持つ
[5] DeepSeek-AI, et al, “DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression,” 2026. https://arxiv.org/abs/2609.19969
[6] Mingyuan Li, et al, “Cross-Model Memory Transfer via Target-Side Reader Adaptation,” 2026. https://arxiv.org/abs/2608.17050、プロジェクトサイトはCross-Model Memory Transfer via Target-Side Reader Adaptation | OLAResearch、コードも公開(OLAResearch/XMemTransfer: Cross-Model Memory Transfer via Target-Side Reader Adaptation)されている。非常に興味深い研究。
[7] 1996年発売のゲーム(ルドラの秘宝 – Wikipedia)。VC ルドラの秘宝に言霊の説明がある。
[8] 色々と作りこみたいところではあるが、まずは実験ということでシンプルに。大枠は ChatGPT 作である。
[9] 採点では、用意した四つの回答候補から、モデルが最も答えらしいと評価したものを選んだ。採点対象は256種類の魔法で、それぞれ二通りの聞き方を使うため、属性と消費魔力を各512問で評価している。(回答候補の文字列に対する対数尤度を比較し、最大の候補を予測とした。属性は0〜3、基本の消費魔力は1〜4を候補とする。途中確認用64種類も二通りの聞き方で評価するため、各属性の分母は128問である。)
[10] 同じファミリーとはいえ異なるモデルであり、このスコア差が何から生じているか検証すると面白そうな予感がある。
[11] 二冊目の記憶表は、属性を変更したデータで別に学習して作成した。
[12] パラメータを変える手法も提案されている(Yuyang Hu, et al, “Memory in the Age of AI Agents,” 2026. https://arxiv.org/abs/2512.13564)……が、現実での利用は計算量的に厳しい。