前の記事では、小型の言語モデルをPost trainingし敬語変換機能を強化した。今回は少し方向を変え、記憶[1]に着目した実験を行った。LLM(Qwen/Qwen3.5-2B-Base[2])に架空の魔導書を記憶させ、その記憶を別のLLM(Qwen/Qwen3.5-4B-Base)で使えるか試してみた。
言語モデルに「記憶領域」を組み合わせるEngram(エングラム)[3]というアーキテクチャがある。短い言葉の並びを用いて学習済みの記憶領域から必要な情報を取り出し推論時に使うもので、人でいうところの記憶のような動作をする。最新のLLMであるQwen3.8-Flash-Next(N-gram Embedding)やDeepSeek-V4.1-Flash(Engram)でも取り入れられている[4][5]。また、記憶を別のモデルへ移す研究「Cross-Model Memory Transfer via Target-Side Reader Adaptation」も発表されている[6]。これは、あるモデルで作った記憶領域を別のモデルにつなぐものである。
本実験では日本語で作った架空の魔導書を使い、Qwen3.5の2Bモデルで作った記憶領域を、4Bモデルへ移してみた。Qwen3.5に追加した記憶領域はEngramを参考に独自に実装しており公式の実装ではない。
まず、4択問題で元のモデルは魔法の属性を95%、基本の消費魔力を96%正解した。これは追加したEngram型の構造により情報を記憶できていることを示唆している。次に学習した記憶を別のモデルに渡した。記憶を渡されたモデルは魔法の属性を55%、基本の消費魔力を67%の正答率で答えた。でたらめな記憶を使った場合は約25%で、四択をてきとーに答えたときと変わらない。学習した記憶は別のモデルでも(一部)使えていた。なお、記憶を差し替えると、変えなくてよい答えまで変化した。このあたりの動きもとても面白い。
記憶させる魔導書について
LLMに記憶させる情報は今まで世の中にはないものが望ましい。そのため、以前はまったプレイヤーが「言霊」と呼ばれる魔法を作れるゲーム、「ルドラの秘宝」[7]の雰囲気で架空の魔法を覚えさせることにした。(名前も設定も今回の実験用に新たに作っている)
三文字の名前を持つ512種類の魔法に、「火・水・風・土」のいずれかの属性と、1から4までの基本の消費魔力を割り当てた。例えば、次のような内容である。
| 魔法の名前 | 属性 | 基本の消費魔力 |
|---|---|---|
| 月雲霧 | 土 | 3 |
| 霞影夢 | 水 | 2 |
| 夢雲霞 | 土 | 1 |
モデルには「夢雲霞の属性は何か」「基本の消費魔力はいくつか」と質問する。前者は土、後者は1が正解になる。名前と性質は意図的に切り離している。「雲」という字があるから風属性、というようには推測できない。加えて、名前の頭に「強」を付けると、属性はそのままで消費魔力が2増える、「転」とつけると属性を次へ変更・消費魔力+1といったルールも用意した[8](が時間の都合上、一部使えなかった設定がある)。
手法
今回使うのは、Qwen3.5に独自の「記憶領域」と「読み取り部品」を追加したモデルである。記憶領域の実体は、質問に含まれる二〜三文字の並び(「夢雲」「雲霞」「夢雲霞」など)を手掛かりに、該当する行の数値を引く表である。読み取り部品は、引いた数値をモデル本体の計算に加えるためのものである。モデル本体のweightは凍結している。追加した記憶領域は約4Mパラメータ、読み取り部品は約0.4Mパラメータである。
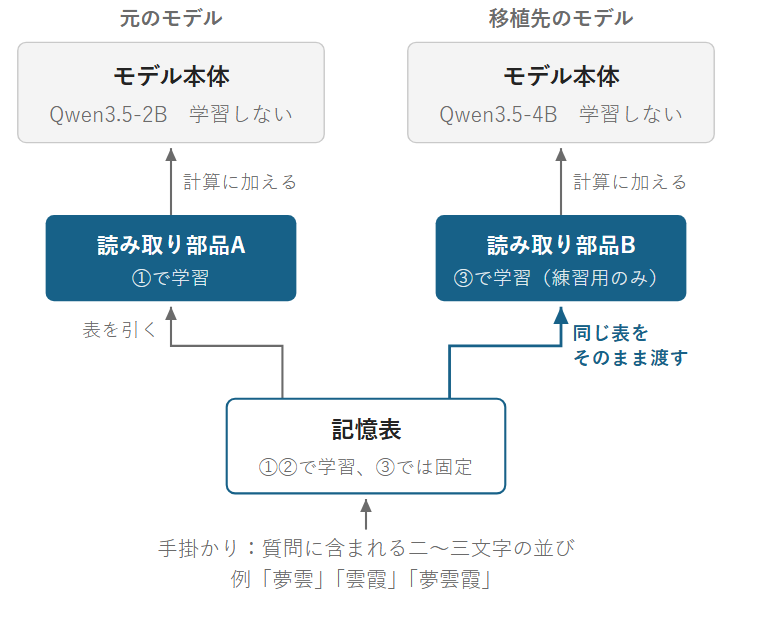
学習は三段階に分けた。
| 段階 | 学習するもの | 固定するもの | 使うデータ |
|---|---|---|---|
| ① 元のモデルで学習する | 記憶領域・表 読み取り部品A | 元のモデル本体(2B) | 練習用の128種類 |
| ② 知識を記憶領域に書き込む | 記憶領域・表 | 元のモデル本体 読み取り部品A | 448種類 (採点用の256種類を含む) |
| ③ 移植先で読み方を調整する | 読み取り部品B | 移植先の本体(4B) 記憶領域・表 | 練習用の128種類のみ |
②で読み取り部品を固定するのは、新しい答えを記憶領域・表以外に覚えさせないためである。③のとおり、移植先でも読み取り部品は学習している。「記憶を渡しただけで、何の調整もせず答えられた」というわけではないことに注意してほしい(とはいえ、③で採点用256種類の答えを使っていないなど変な学習が起きないよう気は使っている)。評価時には4択で答えさせておりランダムだと25%の正解率となる[9]。
比較用として、ランダムな記憶領域・表、記憶を使わない場合を用意した。ランダムな記憶領域・表を使う場合でも、学習した記憶領域・表と同じ条件で読み取り部品を学習させている。これは読み取り部品を学習させただけではスコアが上がらない確認のためである。また、魔導書の差し替え、英語での質問も試してみた。
学習では16例分をためて更新、それぞれの更新回数は2Bが基本1000回、4Bが基本3000回とした(学習対象によって一定しない)。学習にはNVIDIA RTX PRO 6000を用い、①~③の処理に約4時間30分かかった。
結果
① LLM + Engramで知識を記憶できるか? → 記憶できる
Engram型の記憶領域を組み込んだQwen3.5 2Bモデル(元モデル)は魔法の属性を95%、基本の消費魔力を96%正解した。Engram型の記憶領域を作ることで情報の記憶ができ、高い正答率で読み出せたと解釈できる。
| 64種類で評価 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| 元のモデル(2B、記憶領域・表を作った側) | 95% | 96% |
② 記憶した内容は別のモデルでも使えるか? → ある程度使える
日本語の名前を使い、日本語で質問した結果は下表の通り。記憶領域・表を渡すことでスコアが向上しているのが分かる。
| 渡した記憶・情報 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| 学習した記憶領域・表 | 55% | 67% |
| ランダムな記憶領域・表 | 24% | 25% |
| 記憶を使わない | 25% | 25% |
一方で記憶領域・表を作った元のモデル自身の成績とはかなり差がある。
| 64種類で評価 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| 元のモデル(2B、記憶表を作った側) | 95% | 96% |
| 移植先のモデル(4B) | 59% | 65% |
記憶領域・表への書き込みはおおむねできていて、別のモデルで読み出すところで取りこぼしていそうな結果である[10]。
③ 記憶領域を差し替えると答えも変わるか → 変わるが間違いも
次に、属性だけを変えた二冊目の魔導書に差し替えた[11]。二冊目では、採点用256種類すべての属性を「火→水→風→土→火」の順に一つずつずらしている。「夢雲霞」なら土から火に変わり、消費魔力は1のままである。本体と読み取り部品、質問文はそのままで、「別の世界になった」といった説明も加えていない。
面白いことに「夢雲霞」では、二通りの聞き方のどちらでも、正解どおりに答えが切り替わった。
| 「夢雲霞」の正解と回答 | 最初の魔導書 | 差し替え後 |
|---|---|---|
| 属性 | 土 | 火 |
| 基本の消費魔力 | 1 | 1 |
交換の前後どちらでも正しい属性を答えられたのは3割程度。記憶領域を差し替えることで回答を変えられた事例はあるものの正直安定はしていない。
| 確認すること | 条件を満たした組数 |
|---|---|
| 属性が交換の前後とも正しい | 167/512組(33%) |
| 消費魔力が、前後とも正しい | 262/512組(51%) |
| 属性の切り替えと消費魔力の保持を同時に満たす ※「夢雲霞」のような事例 | 79/512組(15%) |
④ 別の言語で記憶を使えるか? → 手がかりとなる情報に依存
日本語で記憶した知識を英語でも使えるか確認した。結果、名前が日本語のままなら、英語で質問しても属性の正答率は落ちなかった。英語名ではほぼランダムな結果だが、答えを含まない対応表を用意することで一部は回復した。
| 質問と名前の条件 | 属性の正答率 | 基本の消費魔力の正答率 |
|---|---|---|
| 日本語の質問・日本語名 | 55% | 67% |
| 英語の質問・日本語名 | 59% | 40% |
| 英語の質問・英語の別名 | 27% | 25% |
| 英語の別名から、日本語名の記憶へ案内する | 45% | 31% |
英語の質問・日本語名の場合、属性は約4ポイント高いが、消費魔力は約27ポイント低い。属性部分の若干の性能向上、属性と消費魔力の差が言語差異によるものなのかは不明だが、とても興味深い結果である。
所感
Engramによる記憶領域の追加と記憶が他のモデルに移せるかを実験してみた。ある程度は効果がありそうでとても興味深い。
現状、新たな知識をAIに使わせる場合はRAGを使用することが多い。GraphRAG、Agentic RAG、その後のAgenticな動作のAI Memoryを含めて記憶部分をコンテキストに入れる設計は変わっていない[12]。EngramはLLM本体のweightとコンテキストの中間に位置するように見え、うまく使えるとLLMの使い勝手が向上しそうである。
この検証はGPT-6 AstraをChatGPTとCodexから使って実施したが、思い付きを実装するのが本当に楽になった。実装確認や結果確認が必須とはいえ、すごい時代になったものだと思う。
脚注
[1] LLMにおいてスキルと記憶は異なるのでは?という研究は昔からある。Knowledge Editingという分野もある。
[2] Qwen/Qwen3.5-2B-Base · Hugging Face, Qwen/Qwen3.5-4B-Base · Hugging Face、いずれもApache-2.0 ライセンス。
[3] Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. https://arxiv.org/abs/2601.07372
[4] Zihan Qiu, et al, “On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability,” 2026. https://arxiv.org/abs/2608.30320、N-gram Embeddingという名称でEngramと近い構造を持つ
[5] DeepSeek-AI, et al, “DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression,” 2026. https://arxiv.org/abs/2609.19969
[6] Mingyuan Li, et al, “Cross-Model Memory Transfer via Target-Side Reader Adaptation,” 2026. https://arxiv.org/abs/2608.17050、プロジェクトサイトはCross-Model Memory Transfer via Target-Side Reader Adaptation | OLAResearch、コードも公開(OLAResearch/XMemTransfer: Cross-Model Memory Transfer via Target-Side Reader Adaptation)されている。非常に興味深い研究。
[7] 1996年発売のゲーム(ルドラの秘宝 – Wikipedia)。VC ルドラの秘宝に言霊の説明がある。
[8] 色々と作りこみたいところではあるが、まずは実験ということでシンプルに。大枠は ChatGPT 作である。
[9] 採点では、用意した四つの回答候補から、モデルが最も答えらしいと評価したものを選んだ。採点対象は256種類の魔法で、それぞれ二通りの聞き方を使うため、属性と消費魔力を各512問で評価している。(回答候補の文字列に対する対数尤度を比較し、最大の候補を予測とした。属性は0〜3、基本の消費魔力は1〜4を候補とする。途中確認用64種類も二通りの聞き方で評価するため、各属性の分母は128問である。)
[10] 同じファミリーとはいえ異なるモデルであり、このスコア差が何から生じているか検証すると面白そうな予感がある。
[11] 二冊目の記憶表は、属性を変更したデータで別に学習して作成した。
[12] パラメータを変える手法も提案されている(Yuyang Hu, et al, “Memory in the Age of AI Agents,” 2026. https://arxiv.org/abs/2512.13564)……が、現実での利用は計算量的に厳しい。