LLMに情報を記憶(Engram)し別モデルへ移植

前の記事では、小型の言語モデルをPost trainingし敬語変換機能を強化した。今回は少し方向を変え、記憶[1]に着目した実験を行った。LLM(Qwen/Qwen3.5-2B-Base[2])に架空の魔導書を記憶させ、その記憶を別のLLM(Qwen/Qwen3.5-4B-Base)で使えるか試してみた。

言語モデルに「記憶領域」を組み合わせるEngram(エングラム)[3]というアーキテクチャがある。短い言葉の並びを用いて学習済みの記憶領域から必要な情報を取り出し推論時に使うもので、人でいうところの記憶のような動作をする。最新のLLMであるQwen3.8-Flash-Next(N-gram Embedding)やDeepSeek-V4.1-Flash(Engram)でも取り入れられている[4][5]。また、記憶を別のモデルへ移す研究「Cross-Model Memory Transfer via Target-Side Reader Adaptation」も発表されている[6]。これは、あるモデルで作った記憶領域を別のモデルにつなぐものである。

本実験では日本語で作った架空の魔導書を使い、Qwen3.5の2Bモデルで作った記憶領域を、4Bモデルへ移してみた。Qwen3.5に追加した記憶領域はEngramを参考に独自に実装しており公式の実装ではない。

まず、4択問題で元のモデルは魔法の属性を95%、基本の消費魔力を96%正解した。これは追加したEngram型の構造により情報を記憶できていることを示唆している。次に学習した記憶を別のモデルに渡した。記憶を渡されたモデルは魔法の属性を55%、基本の消費魔力を67%の正答率で答えた。でたらめな記憶を使った場合は約25%で、四択をてきとーに答えたときと変わらない。学習した記憶は別のモデルでも(一部)使えていた。なお、記憶を差し替えると、変えなくてよい答えまで変化した。このあたりの動きもとても面白い。

記憶させる魔導書について

LLMに記憶させる情報は今まで世の中にはないものが望ましい。そのため、以前はまったプレイヤーが「言霊」と呼ばれる魔法を作れるゲーム、「ルドラの秘宝」[7]の雰囲気で架空の魔法を覚えさせることにした。(名前も設定も今回の実験用に新たに作っている)

三文字の名前を持つ512種類の魔法に、「火・水・風・土」のいずれかの属性と、1から4までの基本の消費魔力を割り当てた。例えば、次のような内容である。

魔法の名前属性基本の消費魔力
月雲霧土3
霞影夢水2
夢雲霞土1

モデルには「夢雲霞の属性は何か」「基本の消費魔力はいくつか」と質問する。前者は土、後者は1が正解になる。名前と性質は意図的に切り離している。「雲」という字があるから風属性、というようには推測できない。加えて、名前の頭に「強」を付けると、属性はそのままで消費魔力が2増える、「転」とつけると属性を次へ変更・消費魔力+1といったルールも用意した[8](が時間の都合上、一部使えなかった設定がある)。

手法

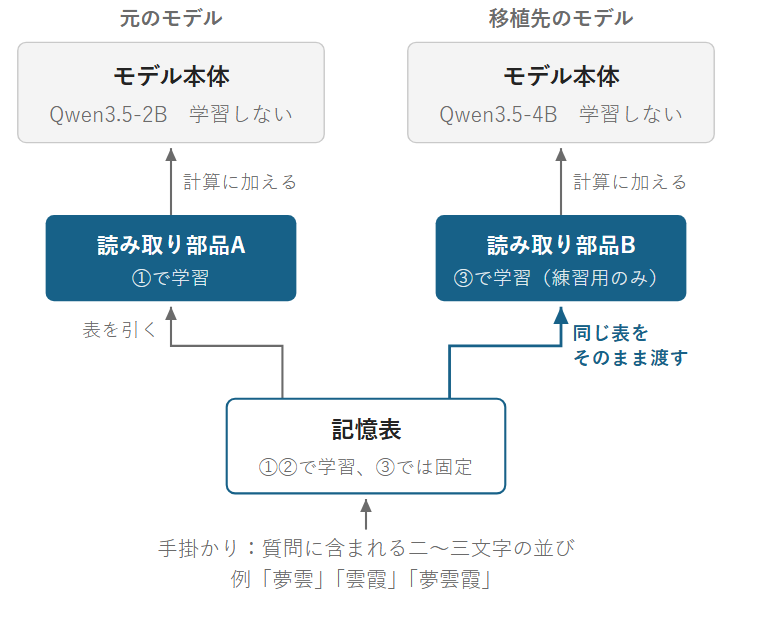
今回使うのは、Qwen3.5に独自の「記憶領域」と「読み取り部品」を追加したモデルである。記憶領域の実体は、質問に含まれる二〜三文字の並び(「夢雲」「雲霞」「夢雲霞」など)を手掛かりに、該当する行の数値を引く表である。読み取り部品は、引いた数値をモデル本体の計算に加えるためのものである。モデル本体のweightは凍結している。追加した記憶領域は約4Mパラメータ、読み取り部品は約0.4Mパラメータである。

学習は三段階に分けた。

段階学習するもの固定するもの使うデータ
① 元のモデルで学習する記憶領域・表
読み取り部品A
元のモデル本体(2B)練習用の128種類
② 知識を記憶領域に書き込む記憶領域・表元のモデル本体
読み取り部品A
448種類
(採点用の256種類を含む)
③ 移植先で読み方を調整する読み取り部品B移植先の本体(4B)
記憶領域・表
練習用の128種類のみ

②で読み取り部品を固定するのは、新しい答えを記憶領域・表以外に覚えさせないためである。③のとおり、移植先でも読み取り部品は学習している。「記憶を渡しただけで、何の調整もせず答えられた」というわけではないことに注意してほしい(とはいえ、③で採点用256種類の答えを使っていないなど変な学習が起きないよう気は使っている)。評価時には4択で答えさせておりランダムだと25%の正解率となる[9]。

比較用として、ランダムな記憶領域・表、記憶を使わない場合を用意した。ランダムな記憶領域・表を使う場合でも、学習した記憶領域・表と同じ条件で読み取り部品を学習させている。これは読み取り部品を学習させただけではスコアが上がらない確認のためである。また、魔導書の差し替え、英語での質問も試してみた。

学習では16例分をためて更新、それぞれの更新回数は2Bが基本1000回、4Bが基本3000回とした(学習対象によって一定しない)。学習にはNVIDIA RTX PRO 6000を用い、①~③の処理に約4時間30分かかった。

結果

① LLM + Engramで知識を記憶できるか? → 記憶できる

Engram型の記憶領域を組み込んだQwen3.5 2Bモデル(元モデル)は魔法の属性を95%、基本の消費魔力を96%正解した。Engram型の記憶領域を作ることで情報の記憶ができ、高い正答率で読み出せたと解釈できる。

64種類で評価属性の正答率基本の消費魔力の正答率
元のモデル(2B、記憶領域・表を作った側)95%96%

② 記憶した内容は別のモデルでも使えるか? → ある程度使える

日本語の名前を使い、日本語で質問した結果は下表の通り。記憶領域・表を渡すことでスコアが向上しているのが分かる。

渡した記憶・情報属性の正答率基本の消費魔力の正答率
学習した記憶領域・表55%67%
ランダムな記憶領域・表24%25%
記憶を使わない25%25%

一方で記憶領域・表を作った元のモデル自身の成績とはかなり差がある。

64種類で評価属性の正答率基本の消費魔力の正答率
元のモデル(2B、記憶表を作った側)95%96%
移植先のモデル(4B)59%65%

記憶領域・表への書き込みはおおむねできていて、別のモデルで読み出すところで取りこぼしていそうな結果である[10]。

③ 記憶領域を差し替えると答えも変わるか → 変わるが間違いも

次に、属性だけを変えた二冊目の魔導書に差し替えた[11]。二冊目では、採点用256種類すべての属性を「火→水→風→土→火」の順に一つずつずらしている。「夢雲霞」なら土から火に変わり、消費魔力は1のままである。本体と読み取り部品、質問文はそのままで、「別の世界になった」といった説明も加えていない。

面白いことに「夢雲霞」では、二通りの聞き方のどちらでも、正解どおりに答えが切り替わった。

「夢雲霞」の正解と回答最初の魔導書差し替え後
属性土火
基本の消費魔力11

交換の前後どちらでも正しい属性を答えられたのは3割程度。記憶領域を差し替えることで回答を変えられた事例はあるものの正直安定はしていない。

確認すること条件を満たした組数
属性が交換の前後とも正しい167/512組(33%)
消費魔力が、前後とも正しい262/512組(51%)
属性の切り替えと消費魔力の保持を同時に満たす
※「夢雲霞」のような事例
79/512組(15%)

④ 別の言語で記憶を使えるか? → 手がかりとなる情報に依存

日本語で記憶した知識を英語でも使えるか確認した。結果、名前が日本語のままなら、英語で質問しても属性の正答率は落ちなかった。英語名ではほぼランダムな結果だが、答えを含まない対応表を用意することで一部は回復した。

質問と名前の条件属性の正答率基本の消費魔力の正答率
日本語の質問・日本語名55%67%
英語の質問・日本語名59%40%
英語の質問・英語の別名27%25%
英語の別名から、日本語名の記憶へ案内する45%31%

英語の質問・日本語名の場合、属性は約4ポイント高いが、消費魔力は約27ポイント低い。属性部分の若干の性能向上、属性と消費魔力の差が言語差異によるものなのかは不明だが、とても興味深い結果である。

所感

Engramによる記憶領域の追加と記憶が他のモデルに移せるかを実験してみた。ある程度は効果がありそうでとても興味深い。

現状、新たな知識をAIに使わせる場合はRAGを使用することが多い。GraphRAG、Agentic RAG、その後のAgenticな動作のAI Memoryを含めて記憶部分をコンテキストに入れる設計は変わっていない[12]。EngramはLLM本体のweightとコンテキストの中間に位置するように見え、うまく使えるとLLMの使い勝手が向上しそうである。

この検証はGPT-6 AstraをChatGPTとCodexから使って実施したが、思い付きを実装するのが本当に楽になった。実装確認や結果確認が必須とはいえ、すごい時代になったものだと思う。

脚注

[1] LLMにおいてスキルと記憶は異なるのでは?という研究は昔からある。Knowledge Editingという分野もある。
[2] Qwen/Qwen3.5-2B-Base · Hugging Face, Qwen/Qwen3.5-4B-Base · Hugging Face、いずれもApache-2.0 ライセンス。
[3] Xin Cheng, et al, “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,” 2026. https://arxiv.org/abs/2601.07372
[4] Zihan Qiu, et al, “On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability,” 2026. https://arxiv.org/abs/2608.30320、N-gram Embeddingという名称でEngramと近い構造を持つ
[5] DeepSeek-AI, et al, “DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression,” 2026. https://arxiv.org/abs/2609.19969
[6] Mingyuan Li, et al, “Cross-Model Memory Transfer via Target-Side Reader Adaptation,” 2026. https://arxiv.org/abs/2608.17050、プロジェクトサイトはCross-Model Memory Transfer via Target-Side Reader Adaptation | OLAResearch、コードも公開(OLAResearch/XMemTransfer: Cross-Model Memory Transfer via Target-Side Reader Adaptation)されている。非常に興味深い研究。
[7] 1996年発売のゲーム(ルドラの秘宝 – Wikipedia)。VC ルドラの秘宝に言霊の説明がある。
[8] 色々と作りこみたいところではあるが、まずは実験ということでシンプルに。大枠は ChatGPT 作である。
[9] 採点では、用意した四つの回答候補から、モデルが最も答えらしいと評価したものを選んだ。採点対象は256種類の魔法で、それぞれ二通りの聞き方を使うため、属性と消費魔力を各512問で評価している。(回答候補の文字列に対する対数尤度を比較し、最大の候補を予測とした。属性は0〜3、基本の消費魔力は1〜4を候補とする。途中確認用64種類も二通りの聞き方で評価するため、各属性の分母は128問である。)
[10] 同じファミリーとはいえ異なるモデルであり、このスコア差が何から生じているか検証すると面白そうな予感がある。
[11] 二冊目の記憶表は、属性を変更したデータで別に学習して作成した。
[12] パラメータを変える手法も提案されている(Yuyang Hu, et al, “Memory in the Age of AI Agents,” 2026. https://arxiv.org/abs/2512.13564)……が、現実での利用は計算量的に厳しい。

arXiv論文整理エージェント FuguReport

論文確認時にAIを使うことが多くなっていることもあり、arXiv最新論文の紹介の完全自動化を行った。今後は「FuguReport」に引っ越す(?)[1]予定である。

FuguReportの概要と実装方針

Fugu ReportにはDaily ReportとWeekly Reportの2つがある。Daily Reportは注目すべき個別論文の紹介、Weekly Reportは週次で注目すべきテーマの紹介を行う構成にしている。大体のイメージは下表のとおりである。

Daily ReportWeekly Report
① 毎日自動作成
② 日次で注目すべき最大5論文を選びそれぞれを要約する
③ 論文の抽出はfugumtのスコアの他、他サイトの注目度を加味する[2]
① 週次で日曜日に自動作成
② 過去1週間に盛り上がった3テーマについてレポートを作成する
③ テーマの選別はfugumtのスコアの他、論文間の距離を利用して遠いテーマを選別する

両レポートともfugumtのスコアを活用している事、ライセンス関係に気を付けている事[3]、日本語と英語版の2つを作成する事は共通である。今のところ基本部分の生成にはGPT-5.4、レビュー修正にはClaude Opus 4.6を用いている[4]。なお、ツールとして独立できる部分はMCP Serverとして分離する構成にしている。次々とツール使っているAI Agentと呼んで良いアーキテクチャになっている。

Daily Reportの生成手法

Daily Reportは下記の方針で生成。オーソドックスなフローとなっている。

  1. 対象論文の選定
    • Creative Commonsライセンスか否か(および本文取得が可能か)、fugumt score、引用件数、SNSやWEBサイトでの言及数[5]などから注目すべき論文を選定
  2. メタデータと論文情報の取得
  3. 著者所属、キーワード及びその階層構造、プロジェクトサイトやgithubリポジトリなど重要情報の取得
  4. Draft(GPT-5.4)→ Review(Claude Opus 4.6)→ Translate(GPT-5.4)の 3 段階で処理

Weekly Reportの生成手法

WeeklyレポートはDaily Reportより凝った構成としている。

  1. 週次で盛り上がったテーマを選定
    • fugumt scoreをベースに対象週の候補論文群を選定
    • 候補論文群のそれぞれの論文のベクトルを求めそれぞれの距離を計算
      • Abstract、論文カテゴリ、キーワードの 3 種 embedding を取得しコサイン距離を計算[6]。
    • 3 テーマ選定、最高スコア論文を 1 テーマ目として採用し、2 本目以降は「選択されたテーマから遠くかつスコアが高い」論文を選択
      ※ テーマの多様性を確保
  2. 各テーマの代表論文の選定
    • 各テーマに関連する論文でCC ZERO、CC BY、CC BY-SAと本文が扱えるものを選定
    • 最大 10 本を比較プールに蓄積し、fugumt score、論文の意味的距離、LLM as a Judgeによる比較選定を組み合わせ、最大 3 本を決定
  3. Introduction / Future Work の抽出
    • 代表論文の本文のうち、IntroductionとFuture Workに関する部分を抽出
      ※ 全く抽出できない場合は次順位の論文を試す
  4. 段階的なレポート生成
    • テーマ現状の生成、代表論文 3 本の Introduction を中心として「主要課題」「研究の方向性」「代表論文の役割分担」を 記述
    • 週内進展の生成、テーマに属する週内論文(上位 10 件)についてテーマのどの点を前進させたかを記載
    • 展望の生成、代表論文 3 本の Future Work と週内進展を入力として「近い将来に増えそうな方向性」「技術的ボトルネック」「次の論点」を記述
  5. 別モデルによるレビューと全文リライト
    • 初稿生成とは別モデルで査読、最終版を確定
  6. 日本語翻訳
  7. インフォグラフィクス生成

週次で盛り上がったテーマ選定に力を入れたフローとなっている。この選定はLLM as a judgeでは困難であり、fugumt scoreやWEB/SNSでの反応といったProxy的な指標が重要となる。段階的な生成と別モデルによるレビューも品質向上には効果があった[7]。

所感

生成AIの品質が向上していることもありレポートのクオリティはかなり高い。しばらくはチェックしながらの運用になると思うがdevneko.jpは3月末で更新を停止する予定である。

いろいろと試していて思ったがDaily Report、Weekly Reportとも難しいのは要約そのものよりも評価に関わる部分、という印象だった。[8]。
※ここ最近のfugumt score推しは上記が原因

対象テーマ選定や対象論文選定ができれば、それ以降の処理は自動化が容易で生成品質も高い。別モデルでのレビューは効果があるので入れているもののレビュー・修正は1回で十分な印象。すごい時代になったなーと思う。

脚注

[1] もはや人が関わっていないので紹介Blogではなく整理システムになっている。
[2] 本文を扱うことが多いので基本的にCreative Commonsライセンスの論文を選択する。
[3] 本文を扱う場合はCC ZERO、CC BY、CC BY-SAの論文を使用する。v1とv2のライセンスが異なる場合もあるので取得可能な全バージョンについて確認している。
[4] 著者所属、カテゴリ、論文分類など基礎情報の整理にはGPT-4.1、GPT-4.1 nano、Mistral Small、DeepSeek V3.2を用いているなど複数のLLM/LRMを使い分けている。
[5] 一部は十分に効いていないので今後強化を行う予定。
[6] Abstractのみよりも効果があった。
[7] 英語での処理を優先しているのはコストパフォーマンスを上げるためである(元データが英語なのでできるだけ英語で扱った方が品質面で有利でありトークンも節約できる)
[8] 実際のところ人間にも難しい。(が、これは凄い!と思う直観が働くことは少なからずある。AIの能力向上でこのあたりも解決するかもしれない。)

arXiv論文と引用の関係、fugumt scoreの検証

前記事の分析時にarXiv論文のソースファイルを取得したので、bibファイルを用いてarXiv論文内で引用がどのように行われているか分析してみた[1]。結果として注目論文を引用した論文が出るまで2-3か月というスピード感、および、fugumtのscoreによる判別力が高注目論文でROC AUCで0.8を超えまずまずの水準であることが分かった。

分析と結果

分析は以下のように実施した。bibファイルを用いて行っているため実際に本文引用されているかは保証していない[2]。また分析対象はAI関連かつソースファイルを取得可能な論文に限られる点にも注意が必要である。

  1. 2024年1月から2025年12月までのarXiv論文についてそのソースを取得し、bibファイルを抽出する[3]。
  2. bibファイルからarXiv IDを抜き出す。
    ※ このIDを引用された論文とみなす[4]。
  3. 引用状況について、発表された論文がどの程度前の論文を引用しているかを分析する。2024年1月から2025年12月のarXiv論文が引用した論文について、被引用論文の発表時期をヒートマップで表す。
  4. 2024年1月から2024年12月に発表された論文についてそのスコアと一定期間後の引用数を集計し、スコアが引用数の予測に役立つかを分析する。

arXiv論文の引用状況

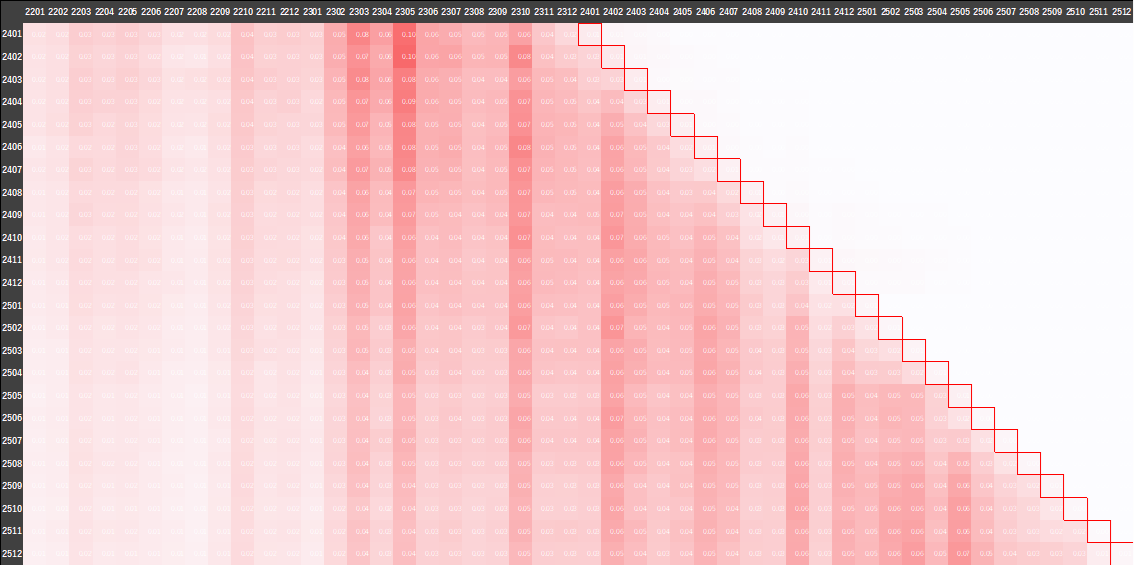
縦軸を論文発表月、横軸を被引用論文の発表月としてその数を集計、全引用数からの割合を算出すると下図のようになる。赤枠になっているのは論文発表月=被引用論文発表月になるマスであり、その右にはタイムラインの関係で論文は出ていないはずである[5]。(ヒートマップには2025年のデータも含めて描画している)

論文の被引用回数を集計すると一部の論文が突出して引用されている。それがうっすらと縦線が見える理由である。例えば2024年10月(横軸=2410)に見える縦線には[2410.21276] GPT-4o System Cardが、2025年5月(横軸=2505)に見える縦線には[2505.09388] Qwen3 Technical Reportが大きく影響している。

縦線が濃くなっていく過程(=注目論文の引用数が増えていく過程)を見ると、上記のような影響度の高い論文が出てからだいたい2-3か月でそれらを引用する論文が発表されているようである[6]。

fugumt scoreの判別力

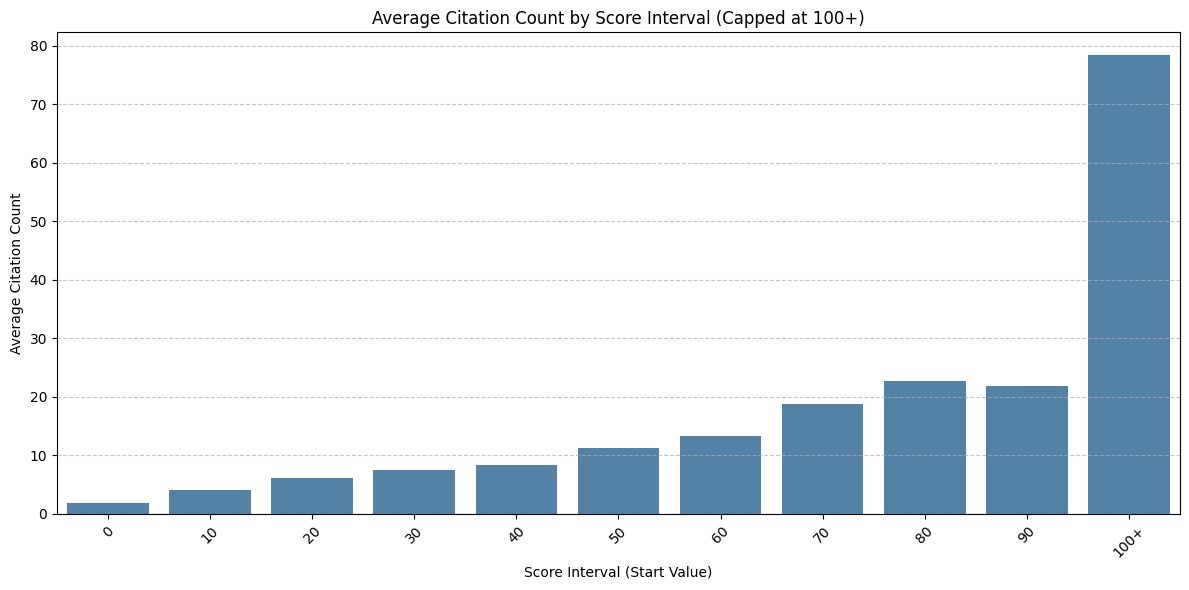
fugumt scoreの品質を検証するため、短期間(論文発表後3か月)、長期間(論文発表後12か月)でスコアとその後の引用数の関係を分析した。結果として発表後3か月で高い引用数になる論文をスクリーニングする上で一定の効果があることが分かった。

下図のように長期間でもスコアと平均引用数はまずます良い関係にありそう[7]。
※スコア100超は前述のヒートマップで線が見えるような極めて引用数の多い論文が含まれるので注意が必要(もっともそれを予測できているともいえる)

  • == 分析対象期間: 3_months (公開から 3 ヶ月以内) ===
    • データ数 (n): 107,281 件
    • ROC-AUC (被引用数 > 0): 0.6520
    • ROC-AUC (被引用数 >= 10): 0.8100
      • 10回以上引用された割合: 1.08% (1,159件)
  • === 分析対象期間: 1_year (公開から 12 ヶ月以内) ===
    • データ数 (n): 107,281 件
    • ROC-AUC (被引用数 > 0): 0.6566
    • ROC-AUC (被引用数 >= 10): 0.7528
      • 10回以上引用された割合: 9.86% (10,576件)

所感

bibファイルからarXiv内の引用関係を分析してみた。現状、重要な論文が出ると3か月程度でその論文の引用数が増加するようである。国際会議を待てない現状に沿った結果になっていて、AI研究のスピード感がすごいことが分かる。

論文を探すうえでは当初3か月程度はfugumt scoreのような代替指標が必要になるかもしれないが、それ以降は引用数を使ってもよさそうに思えた。1年程度すれば国際会議発表を引用する事例が支配的になるはずで短期、中期、長期で指標を変えるのがよさそうである[8]。

脚注

[1] あくまでarXiv内の分析となっている。国際会議等で発表後はそれを引用することが多いため参考程度の情報。もっとも3か月というスピード感ではarXivを引用することが多いと思われるので実態には近いと思っている。
[2] 引用していないとしても参照していることは確かで意味はあると思っている。
[3] 発表月の判定はarXiv ID(.の前の4桁の数字)で行っている。
[4] 主要論文についてはこの処理で引用数として概ね妥当な数が出ることを確認している。
[5] 実際はID抽出時のノイズやバージョン差異の状況などにより0にはならない。が概ね良い結果になっている。
[6] 肌感にも合うが本当にスピードが速い。
[7] ROC AUC > 0.75はあるものの短期に比べROC AUCが低くなっている。これは国際会議を通した引用等によってarXivを参照することが減っていくことと整合的に思える。
[8] 短期は3か月未満、中期は半年程度、長期は1年以上を想定している。

arXiv論文の分析(研究機関別分析)

5年間以上運営しているFugu-MT: arxivの論文翻訳(概要)に関連しarXivデータを用いた研究機関別の分析を行った。分析データ構築からLLMを積極的に活用[1]、各研究機関の違いなど興味深い結果が出た[2]。

分析の方法

研究機関別の状況を分析するため、まずはarXivデータを基礎として著者所属の取得と論文のカテゴリ判定を実施した。fugumt.comで付与しているスコアも利用し分析を進める手順とした。基礎データ作成時にはコスト削減のための工夫を行っている[3]。基礎データ作成後の分析はChatGPT(GPT-5.4 Pro)とClaude(Sonnet 4.6拡張)に任せた[4]。

  1. arXivのTeXデータをダウンロード、main部分のTeXソースを取得し、著者情報や所属が書かれていると思われる部分をヒューリスティックに取得する。
  2. 取得した情報からLLMで著者情報、所属を取得する。さらにLLMを用いて表記ゆれを排除する。
  3. 取得が失敗した論文についてはPDFデータをダウンロードしテキスト抽出処理を行う。
    ※PDFから抽出したテキストと画像データをLLMに投入、著者情報と所属を取得、LLMを用いて表記ゆれに対処する。
  4. fugumt.comで収集した論文情報(著者一覧、アブストラクト)を用いて各論文をスコアリングする[5]。加えてアブストラクトから論文カテゴリとキーワードを抽出、LLMを用いて上位カテゴリを推定、3階層の構造に変換する。
    ※ Fugu-MT:arXivの最新論文 のスコアが70を超える論文にarXiv over_70というフラグを付けている。
  5. 著者、所属、キーワード、カテゴリについてマッピングテーブルを用いて表記を統一する[6]。
    ※LLMのみでは対応の難しい表記ゆれに対処する。
  6. 整理したデータをChatGPTとClaudeで分析する。

基礎データ構築は「数十万本の多様な論文を様々な手法で整理する」という泥臭く大変な作業だった…ということで6.の分析は既存ツールに任せている。大変な部分は人間が実施、面白いところはAIが実施と、いかにも今っぽい分業になっている。

分析結果

AIによる分析結果は次の通り。全体的に面白く[7]、下記の言い切りはなかなか凄いと思う。スコアリングや集計方法による影響もあるが、新規参集の研究者が増えている傾向、重要論文の比率が相対的に下がっているのではないか?という懸念など一定の納得感がある。

「論文が増えれば影響力のある研究も増える」とは限らない。2025年は明確に、投稿量の膨張が注目度の成長を上回った年だった。

over_70比率:18.6%(2024)→ 15.7%(2025)、−2.9pt

ぜひ、分析結果とプレゼンテーション資料を見ていただきたい。

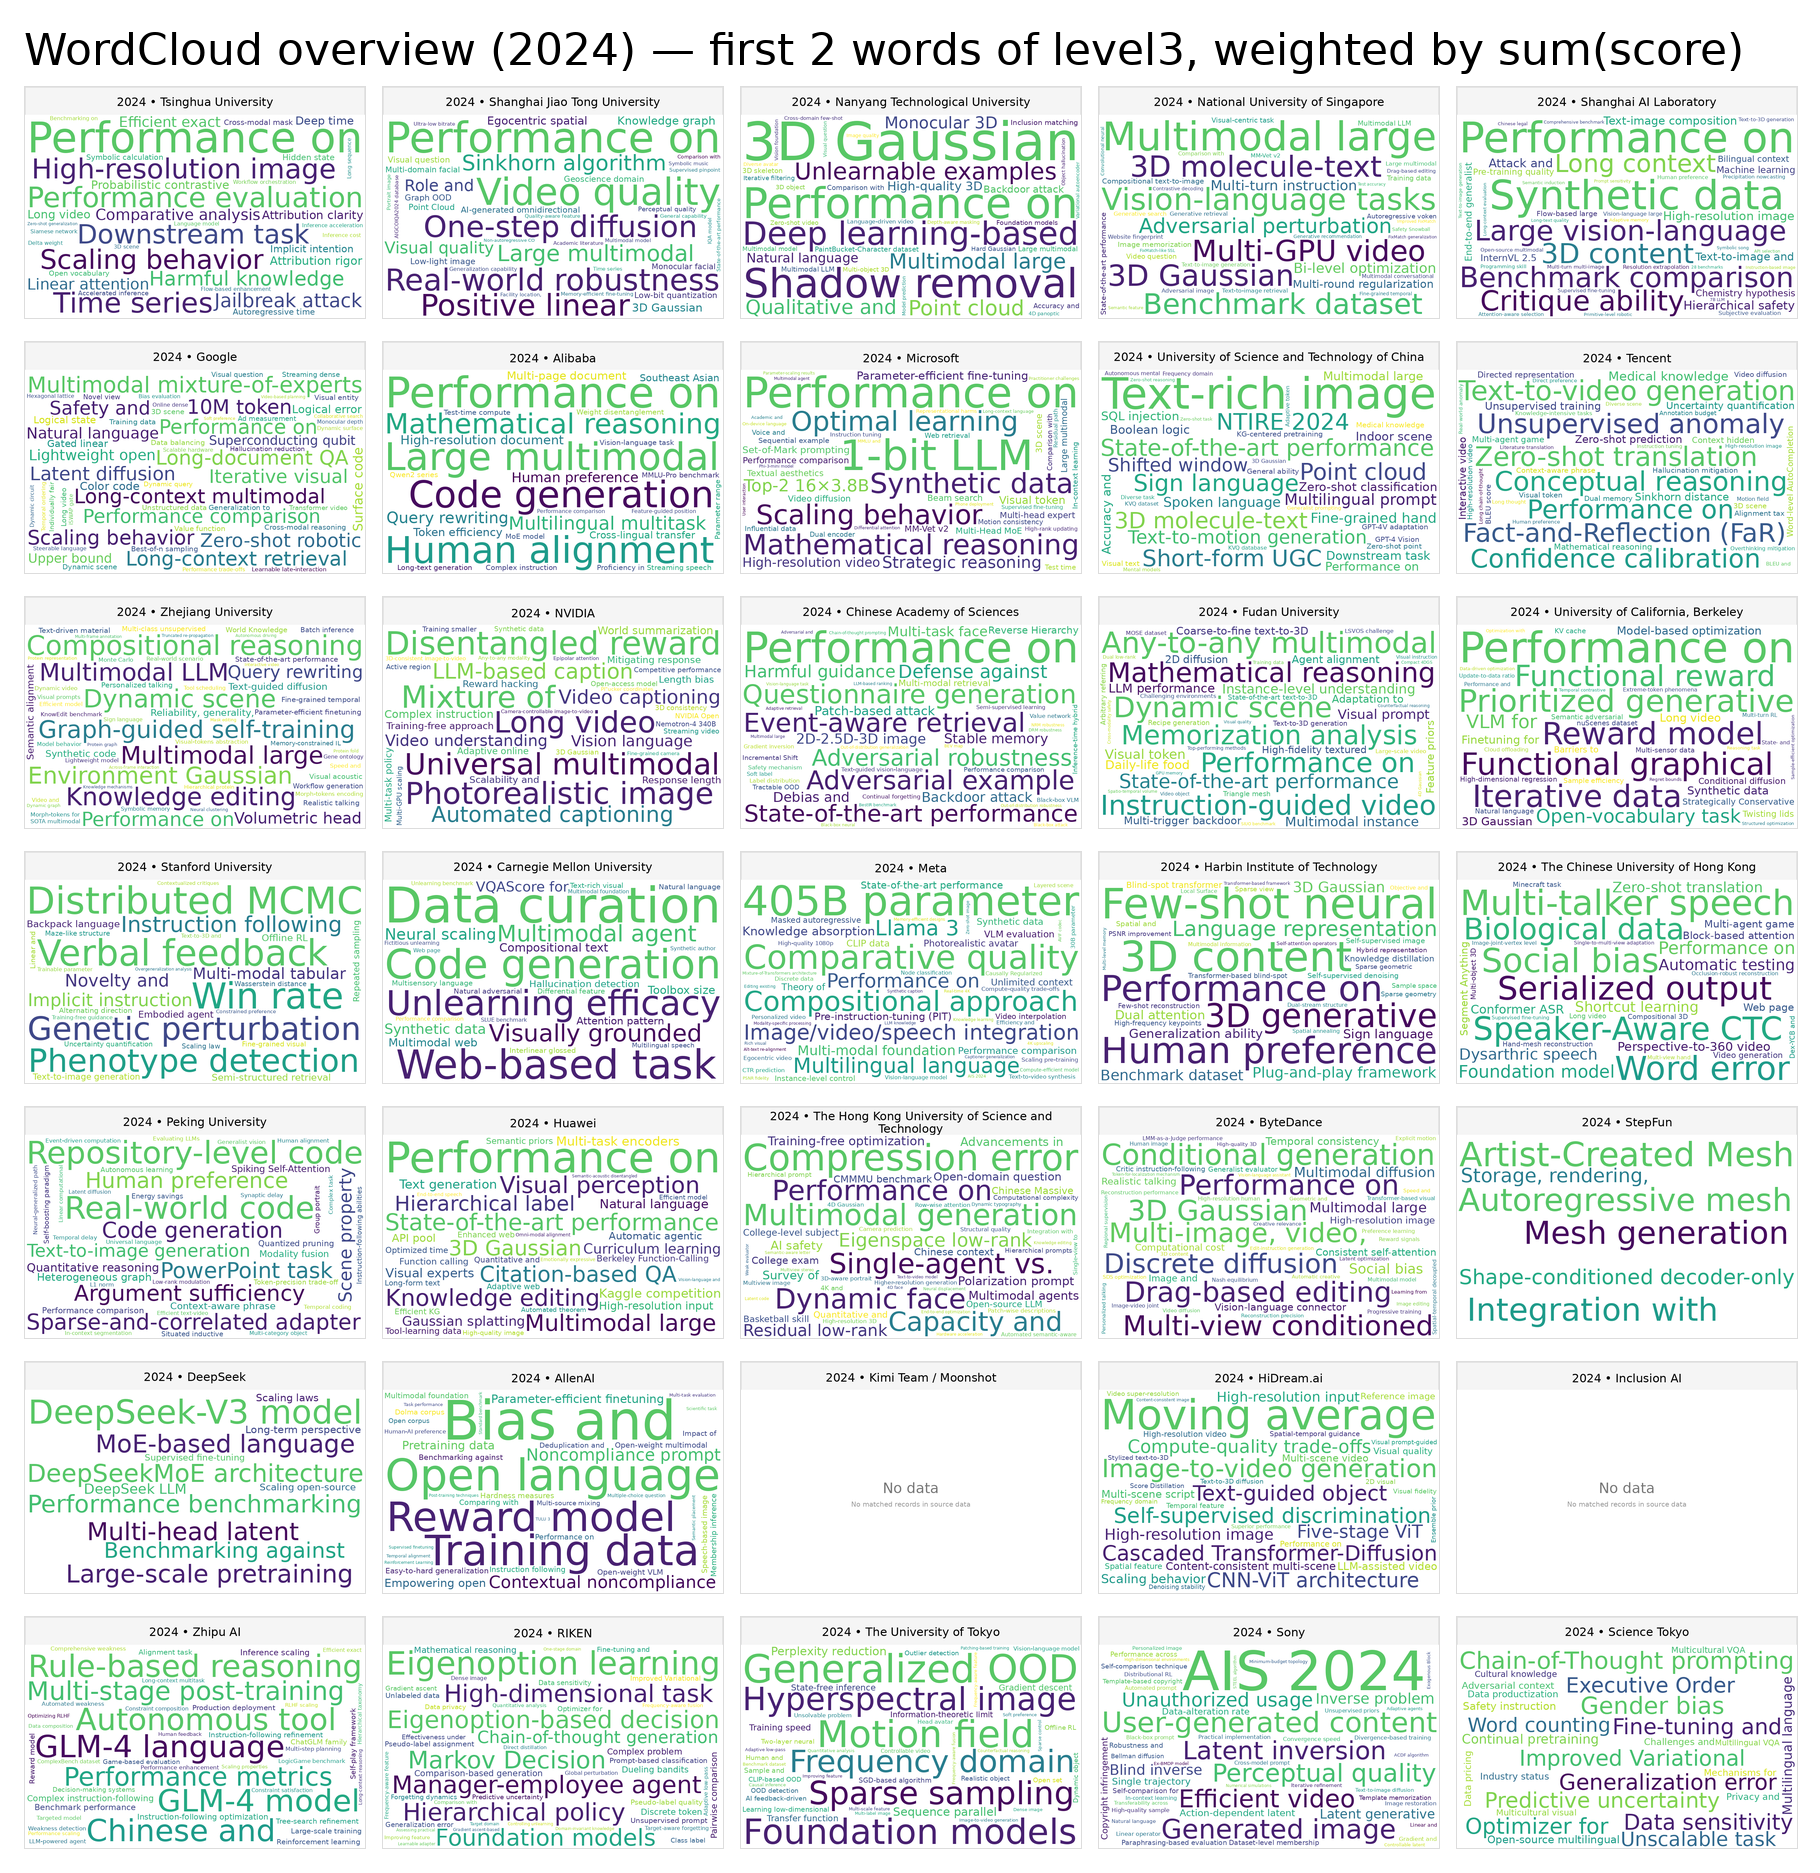
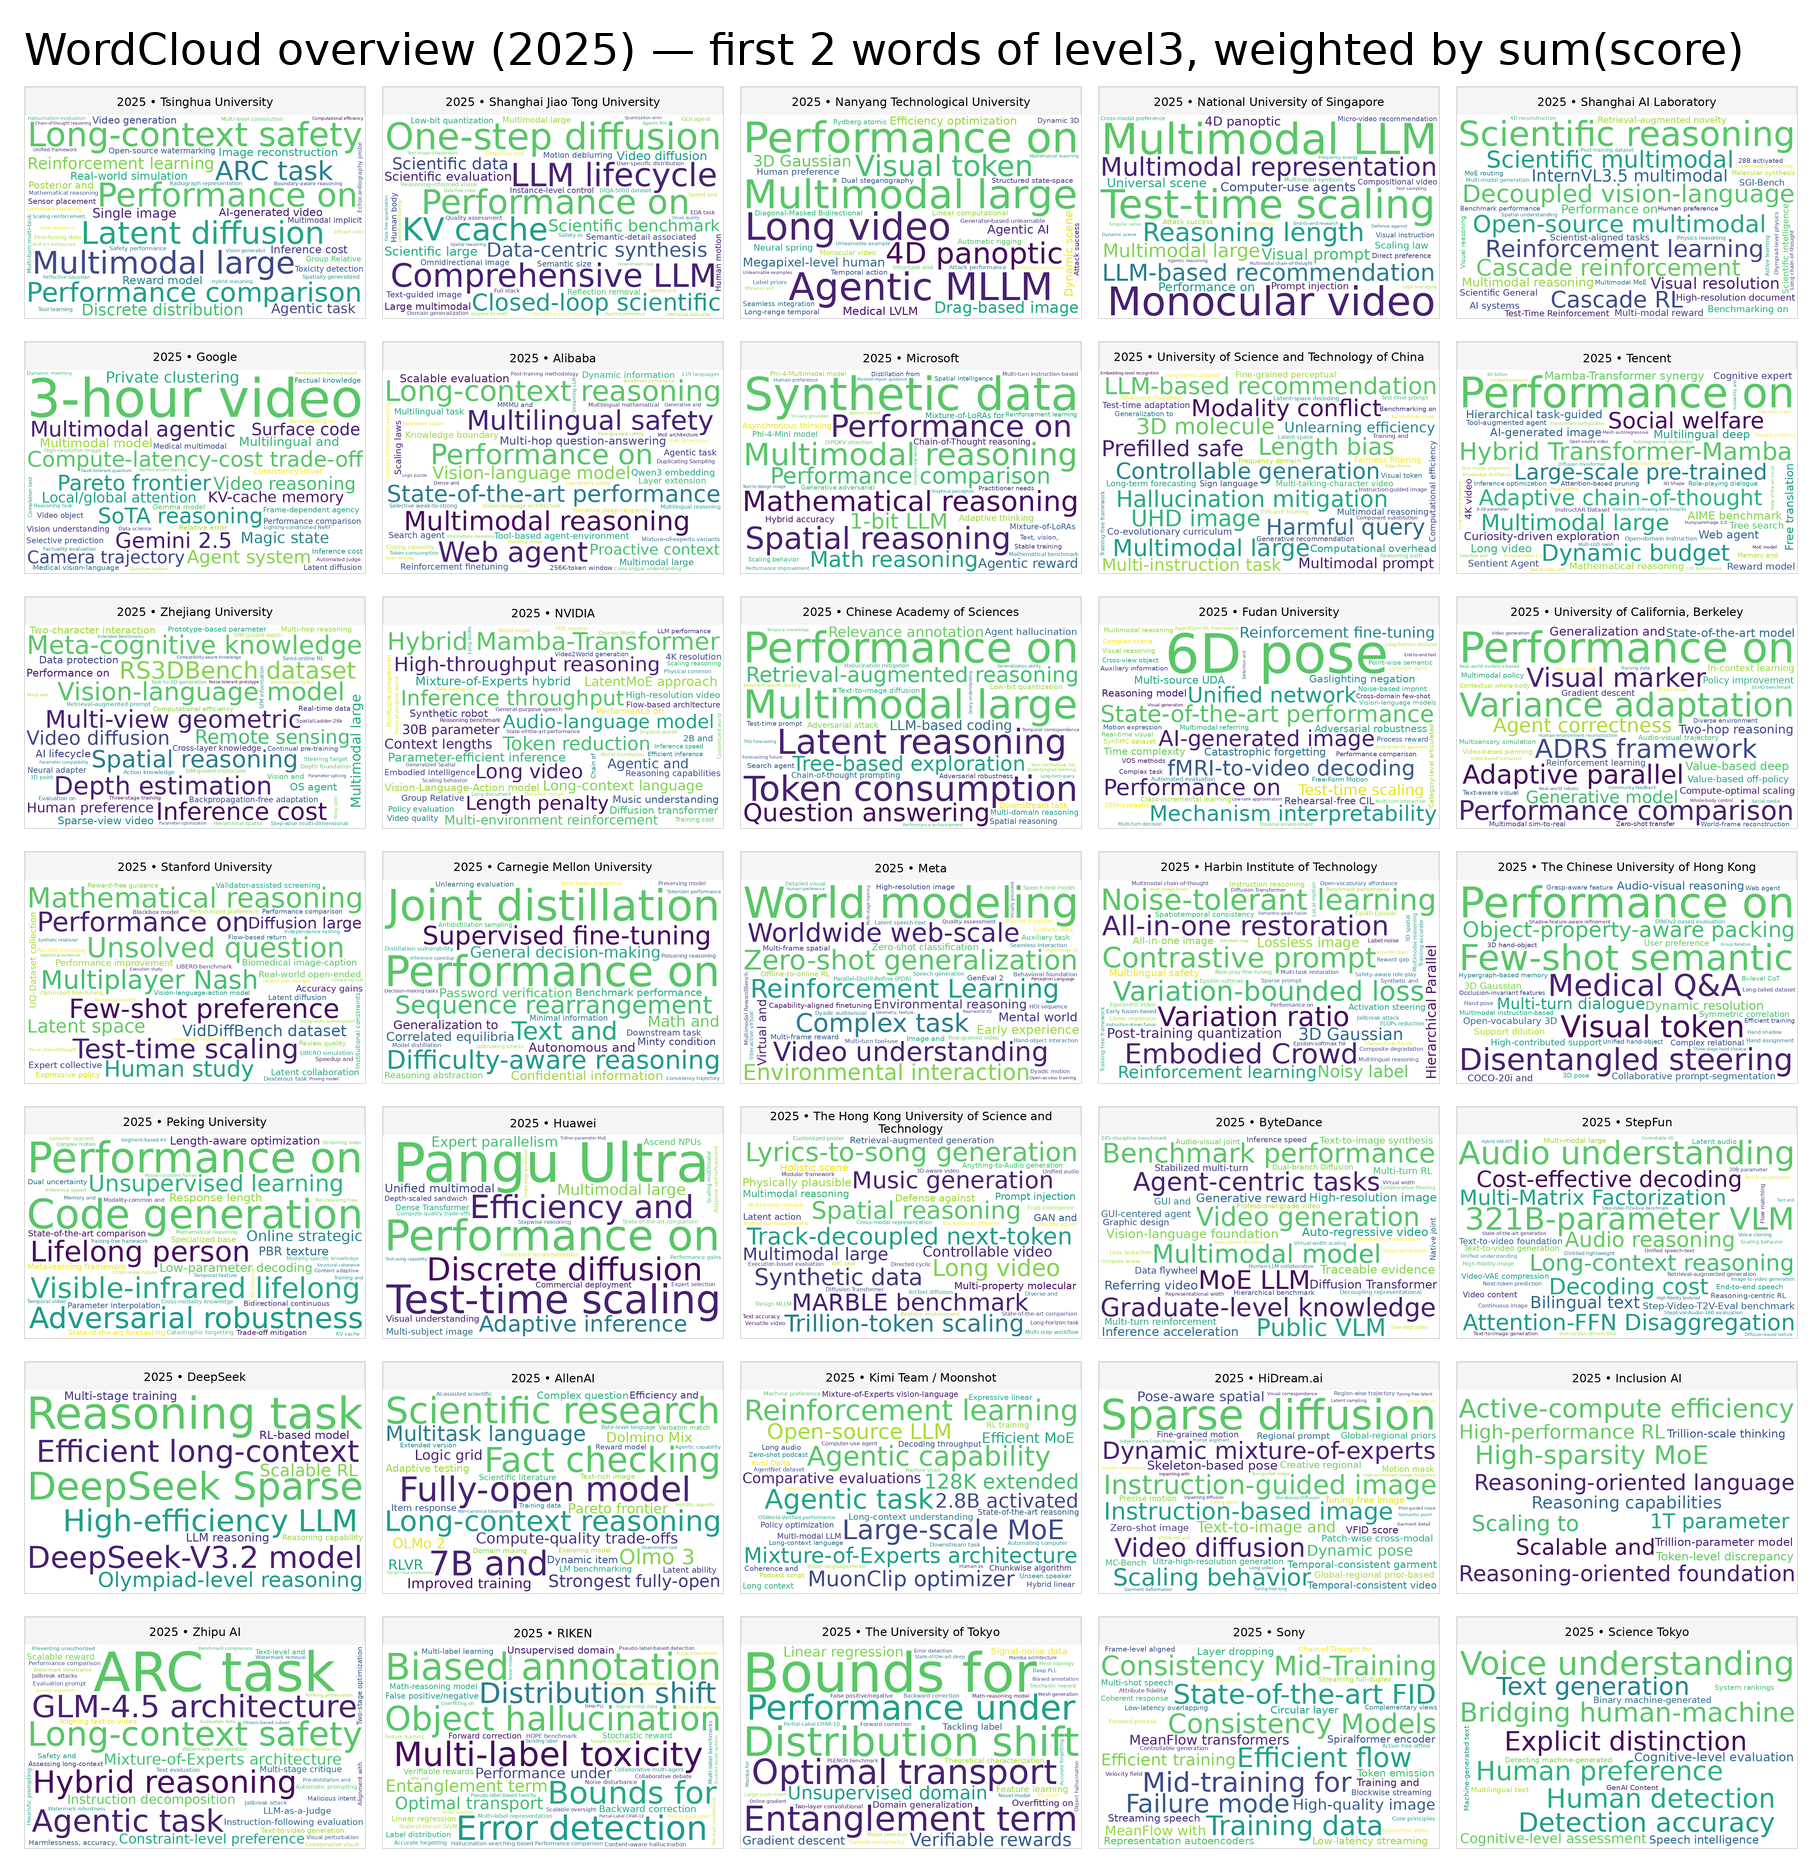
世界のAI研究機関、いま何で戦っているのか — arXiv × NeurIPS データで読み解く2025年の研究地図 (プレゼンテーション資料:arxiv_report_2025_ja.pdf、2024年のワードクラウド、2025年のワードクラウド)

せっかくなので英語版も作ってもらった。Who’s Winning the AI Research Race, and How — Mapping 2025 Through arXiv and NeurIPS Data(arxiv_report_2025_en.pdf)

特に下記、研究ポートフォリオの分析結果はなかなか興味深い。

大学・企業・スタートアップ
セクター別の戦い方

企業:LLMを核にEfficiencyとRLに賭ける

Microsoft・NVIDIA・Google・Alibaba・Tencent——いずれもポートフォリオの30〜36%をLLM/Foundation Modelsが占める。その上に何を重ねるかで差が出る。MicrosoftはEfficiency(15%)と評価(21%)の三位一体、NVIDIAはEfficiency(14%)とScaling(18%)で推論インフラを強化、AlibabaはRL/Agents(18%)でQwen系のagentic拡張に注力している。

大学:評価・ベンチマークが共通の主軸

上位6大学(清華・SJTU・NUS・Berkeley・Stanford・Fudan)のカテゴリ分布を並べると、すべての大学でEval/Benchmarkが最大テーマ(31〜44%)という共通点が際立つ。大学が「評価インフラ」を担うというエコシステム上の役割分担が、データに明確に表れている。差異はその外側にある。BerkeleyはRL/Agents(11%)とScaling(8%)が高く、embodied AI・sim-to-realの先端を行く。Stanfordは評価設計・Preference Optimizationを軸に agent の研究ループを主導。Fudanの Eval 44% は大学群で最大の特化度だ。

スタートアップ:NeurIPSを待たず、戦略は今見えている

スタートアップ各社の研究ポートフォリオは、一枚岩ではない。大きく二極に分かれている。

総合型:StepFunはLLM・Efficiency・GenAI/Videoを同時に展開し、既存大手に最も近いbroad portfolioを持つ。Kimi/MoonshotはMoE・長文・agentic benchmarkを前面に出しEfficiency 25%が際立つ。

極特化型:DeepSeekはLLM+RL+Evalの3テーマだけで構成され、reasoning・attentionへの集中度は全機関中最大。HiDreamはGenAI/Video 63%と完全な diffusion/media 特化だ。

所感

分析はChatGPTとClaudeに任せたものの「③ 新興勢の発見はNeurIPSを待たない
 StepFun・Inclusion AI・DeepSeek——これらはarXiv over_70で先に信号を出した。査読会議への反映は6〜18ヶ月遅れる。先行指標として over_70 を使えば、競合分析の精度が上がる。」とFugu-MT: arxivの論文翻訳の有効性を示したのは少し嬉しかった[8]。

大学と企業の違いであるとか、研究ポートフォリオ構成はなかなか面白い示唆だと思う。著者別の分析や共同研究の状況など細かく見ていると様々な発見がありそう。もっとも見方によってスコア分割の方法などを決めないといけないなど細かい部分はChatGPT、Claudeとも今一歩という印象がある。時間があれば私自身の手でも分析してみたい。

今っぽいと言いつつ「大変な部分は人間が実施、面白いところはAIが実施」が一般化すると嫌だなーと思う。泥臭い部分を含めてAIに任せられる日は来るのだろうか…[9]

脚注

[1] データ準備段階では所属研究機関抽出と表記ゆれの解消、論文カテゴリとキーワードの分類、階層構造の作成などに活用。データ分析自体は完全にAIにまかせた。これらを処理するプログラム作成は概ねCodexにまかせている。
[2] 若干無理のある仮定はあるが、大きな認識のずれはない。
[3] 分析予算は上限1000USD。かかったコストはAWSからの転送コストとLLM APIの利用料が主。PDFから著者情報を取得するアプローチ(3.)だとコストが10倍以上かかると予想されたため現状のパイプラインとなっている。
[4] 様々な角度からの集計や分析はGPT-5.4 Proの強さが目立ち、プレゼンテーション作成はClaude Sonnet 4.6のうまさが目立った印象。
[5] 論文著者の過去の実績(主としてトップカンファレンスでの採録数)をベースにスコアを決めている。論文内容自体の評価でない点には要注意ではある。
[6] マッピングテーブルはヒューリスティックな手法、ルール(典型的なノイズ削除)に加え、LLMの内部知識の活用とそのチェックなど、複数手法を組み合わせて作成している。
[7] ストーリーやメッセージの甘さなど指摘事項は多数あるとはいえ、読み物として面白い。
[8] fugumtのスコアリングも過去のカンファレンス実績をベースにしているのでやや誇大広告ではある。ただ、先行指標としては有効なのは本当。研究機関のスコアと次の年のNeurIPS発表数の相関係数はかなり高く、over_70の相関係数はさらに高くなる(1年後としてr=0.744)。ランキングの評価ではHuggingFace Daily papersと比較してROC AUC > 0.8など注目論文のproxy的な指標としてもまずまずの性能。発表後3か月で引用数10を超える(arXiv内でTOP 1%の論文)の判別力もROCAUC > 0.8。AIのように動きの速い分野では研究機関別のトラックレコードを見るよりも研究者の動向、共同研究の動向や所属の変化を見たほうが実態に近くなる。(とはいえ研究の質とまで言い切るのは危険。他に良いProxy指標が無いので無理を承知で使ってみたというのが実態に近い。)
[9] それはそれで人間がいらなくなる未来になってしまうわけだが・・・

Qwen2-7B, GLM-4-9Bの機械翻訳性能

中国からもWeightを公開している or オープンなモデルの発表が続いている。いつもの通り機械翻訳性能を検証してみた。性能評価に使用したデータは以前(DAMO PolyLM-13Bの機械翻訳性能 | ぷるーふおぶこんせぷと (staka.jp))と同じ。検証環境は環境はColab Pro+を用いた。基本的にfp16で扱っている。

本件の検証でもGPT-4oを用いて回答抽出を行った結果を併記しているが、基本的に指示への対応は安定していた。評価指標はBLEU、使用したツールやtokenizerは以前と同じ(sacrebleu –tokenize ja-mecab)である。「0 shot」と「1 shot」の比較でICLやRAGなどプロンプト内にデータを与えた時の性能、「出力そのまま」と「GPT-4で回答抽出」の比較で指示のしやすさをザックリとみる事ができる。いつもの通り非常に限定された機械翻訳ベンチマークである[1]ことに注意が必要である。

モデル0 shot /
出力そのまま
0 shot /
GPT-4oで回答抽出
1 shot /
出力そのまま
1 shot /
GPT-4oで回答抽出
Qwen/Qwen2-7B-Instruct · Hugging Face20.520.429.730.0
THUDM/glm-4-9b · Hugging Face25.525.530.430.6
Qwen2, GLM4の機械翻訳性能

結果と所感

Qwen2 7B、GLM 4 9Bとも機械翻訳性能は高い。さすがマルチリンガル利用を想定され構築されたモデルである。Qwen2とGLM4の性能差はパラメータサイズによるものに見える。

今までの検証結果を振り返ると、同様に構築されたAya-23 8B [2]と比べると出力の安定性(使いやすさ)はQwen, GLMが優れ、絶対性能は競合的またはややAya-23が優位といえそう [3]。

サイズが近く有名なモデルにはMistral 7B v0.3やGemma 7B、Llama 3 8Bがある。これらと比べると0 shot性能ではQwen, GLMが優れ、1 shot性能はほぼ互角である。0 shot性能はLLM内の知識に依存し、日本語での継続学習・SFTを行うと性能拡張の余地も大きそう。

Qwen2 7BはApache-2ライセンスと完全なOSSであることも重要。絶対性能が高く、命令追従性が良い、かつ、周辺ツールもよく整備されている強力で使いやすいモデルであるように思う。

脚注

[1] このあたりのザックリ感はいつもと同じ。
[2] Aya-23はCC-BY-NCと商業利用が禁止されているため使いどころは限られる。
[3] BLEUで測れるのかという話はあるが…

The Pileの構成(なぜCerebras-GPTで日本語が使えるのか?)

ChatGPTが盛り上がる中、オープンライセンスなLLM(大規模言語モデル)開発も行われている。その中でCerebras-GPT(Cerebras Systems Releases Seven New GPT Models Trained on CS-2 Wafer-Scale Systems – Cerebras)が日本語を使えると聞いて試してみた。

Colab Pro +でA100 GPUを使うと、cerebras/Cerebras-GPT-6.7B · Hugging Faceにそって6.7Bのモデルを動作させることができる[1]。

import torch
device = torch.device('cuda:0' if torch.cuda.is_available() else 'cpu')

from transformers import AutoTokenizer, AutoModelForCausalLM
from transformers import pipeline

tokenizer = AutoTokenizer.from_pretrained("cerebras/Cerebras-GPT-6.7B")
model = AutoModelForCausalLM.from_pretrained("cerebras/Cerebras-GPT-6.7B")

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer, device=device)

text = "猫と暮らして10年になる人に聞いた、猫と一緒に暮らすときに必要なもの第1位は"
generated_text = pipe(text, max_length=500, do_sample=False, no_repeat_ngram_size=2)[0]
print(generated_text['generated_text'])

上記の出力は「猫と暮らして10年になる人に聞いた、猫と一緒に暮らすときに必要なもの第1位は「笑顔」。続いて「恋愛」、「自分のことを知っている」という結果に。」[2]、なお、2.7Bパラメータの場合は「猫と暮らして10年になる人に聞いた、猫と一緒に暮らすときに必要なもの第1位は、それぞれの人間が笑っているということです。」[2]だった。

model = AutoModelForCausalLM.from_pretrained("cerebras/Cerebras-GPT-13B", torch_dtype=torch.float16)

としてCerebras-GPT-13Bを使った時の結果は「猫と暮らして10年になる人に聞いた、猫と一緒に暮らすときに必要なもの第1位は、「笑顔」。結果、それは私の言葉ではなく、自分のものである。」[2]だった。

日本語を使えると言っても性能はかなり微妙な感じ。
※以降、理由を探っていくが本来使えないはずの日本語っぽい文字列が表示されるのは結構すごいというのが全体的な感想。

The Pile

Cerebras-GPTシリーズはデータセットとしてThe Pile[3]を用いている。論文に書かれている通りThe Pileは英語のデータセットである。そのため基本的には日本語を使えないはずなのだが、The Pileを用いて学習されたLLMは日本語をある程度解釈しているのでは?と思う動作をする。これはThe Pile構築で使われたデータセットに意図せず日本語が含まれているためと言われている。前置きが長くなったが、本記事ではこれが本当なのか検証する。

検証方法

The Pileをダウンロードし含まれる文字を文字別にカウントし、下記条件の文字を日本語と考えて日本語の構成比率を算出した。CJKの名の通り日本語ではない用例の漢字を含めて数えており明らかに日本語分を多くカウントしているという問題があるのだが、ここではいったん無視することにする[4]。

  • UnicodeのBlock=Hiragana
  • UnicodeのBlock=Katakana
  • UnicodeのBlock=CJK Unified Ideographs

The Pileのデータを展開しながら文字別カウントし、その後、上記条件をregexでチェックし日本語と全体の文字数を集計した。Pythonで適当に書いた感じc6a.xlargeで1プロセス辺り9Mバイト/秒程度の速度で処理ができた。2プロセス並列させると1日以内に処理が終わるイメージである。

検証結果

検証結果は次表の通り。The Pileにおける日本語の構成比率はわずか0.07%(約900 M文字)だった。日本語に貢献しているデータセットは「OpenWebText2」「Github」が大きく、続いて「YoutubeSubtitles」だった。

データ名全体の文字数うち日本語日本語構成比率
■全体1,297,182,716,948889,523,7340.07%
Pile-CC230,770,471,68714,799,6330.01%
PubMed Central181,751,973,64018,441,2010.01%
Books3153,023,754,59930,846,0520.02%
OpenWebText2124,271,071,981390,955,6250.31%
ArXiv113,558,856,961307,7740.00%
Github96,487,741,975314,200,4230.33%
FreeLaw79,956,003,3662,8320.00%
StackExchange64,805,917,11319,770,0980.03%
Wikipedia (en)50,611,222,0865,979,9760.01%
USPTO Backgrounds47,025,652,53400.00%
PubMed Abstracts39,086,727,4677300.00%
Gutenberg (PG-19)26,723,093,69917,8450.00%
OpenSubtitles19,750,201,47835,0700.00%
DM Mathematics15,719,095,09600.00%
Ubuntu IRC11,184,940,47100.00%
BookCorpus29,378,252,620833,3340.01%
EuroParl8,516,900,087200.00%
HackerNews7,872,312,50577,7930.00%
YoutubeSubtitles6,431,579,29193,060,4371.45%
PhilPapers4,745,004,923194,8910.00%
NIH ExPorter3,814,590,93000.00%
Enron Emails1,697,352,43900.00%
The Pileの日本語構成比率

なお、日本語として含まれる文字のトップ5は次の通りだった[5]。ひらがなの出現頻度が通常と同じなのかは疑問ではある。

  1. 「の」約20M文字
  2. 「い」約14M文字
  3. 「的」約13M文字
  4. 「に」約13M文字
  5. 「る」約12M文字

結果とまとめ

オープンなLLM開発でよく使われるデータセット、The Pileの構成文字から日本語の比率を考えてみた。結果、多めに見積もって900M文字、構成比率0.07%と非常に少ない。この程度しか入っていないにもかかわらず日本語文として一定程度成立した文が返ってくるCerebras-GPT-6.7Bは凄い。

脚注

[1] GPUで動作させる部分だけ若干コードを追加している。cerebras/Cerebras-GPT-13B · Hugging Faceは書かれた手順ではメモリ不足になる。float16にすれば動作する。
[2] この後改行して「私は、それぞれの言葉についちゃった。「お父さん、こんなに美しい犬がいますか?」「この人、あなたのほうが素敵ですよ」」・・・と謎の文字列が続く。
[3] Gao, L., Biderman, S., Black, S., Golding, L., Hoppe, T., Foster, C., Phang, J., He, H., Thite, A., Nabeshima, N., Presser, S., and Leahy, C. 2020. The Pile: An 800GB Dataset of Diverse Text for Language Modeling. arXiv preprint arXiv:2101.00027.
[4]とても雑なことは承知しつつ、日本語判定は結構難しく判定に凝ると処理時間の問題が出るため今回はこの条件で検証した。日本語分を多めにカウントしていて出た結果で結論には影響しない。
[5] 「的」が入っているのは中国語も入っているからかな?と思う。

その他

The Pileを使って構築した大規模言語モデルで何故か日本語が使えるのは知られていた。その理由としてGithubデータセットの日本語コメントによるものなどの理由を聞いたこともあったが、本当か確証がなかったので調べてみた。結果当たらずも遠からずという感じだった(構成要素としてはそれなりに多いが半分は超えていない)。

個人的には1G文字いかないレベルのデータで日本語能力を学習していることに驚きだった。疑問に思ったことは調べてみると面白い。The Pileにwikipedia-jaのデータを混ぜるだけでも日本語能力はかなり上がるんじゃないだろうか。BlinkDL/rwkv-4-raven · Hugging Faceのように1%程度でも日本語が入っていると結構な効果がありそうに思う。

機械翻訳でのIn-Context Learning(GPT-4 + OpenICL)

GPT-4とGPT-3.5 + OpenICL[1]を用いて機械翻訳におけるICL(In-Context Learning)を検証してみた。結果は下表の通りでプロンプトの動的生成には大きな効果があった。

プロンプトの条件GPT-3.5[2]GPT-4[3]FuguMT[4]
ゼロショット、事例無し27.230.231.3
対応するページのタイトル(英語・日本語の両方)29.631.8–
OpenICL / RandomRetriever
※ gpt-3.5のトークン数に沿って1-2 shot
※ 翻訳例をランダムに参照しているイメージ
28.030.6–
OpenICL / TopkRetriever①
※ gpt-3.5のトークン数に沿って1-2 shot
※ 翻訳例から対象に近い事例を参照しているイメージ
34.734.5–
OpenICL / TopkRetriever②
※ 全ての試行で3-shot
※ 翻訳例から対象に近い事例を参照しているイメージ
–35.3–
GPT-3.5, GPT-4でプロンプトを変えた場合及びOpenICL利用時のBLEU

性能評価の方法

性能評価に使用したデータは前回(GPT-4を用いた翻訳の検証(vs GPT-3.5 vs FuguMT) | ぷるーふおぶこんせぷと (staka.jp))と同様としOpenICLの効果を検証した。

  • ChatGPT API(gpt-3.5-turbo-0301)、GPT-4 API(gpt-4-0314)、FuguMT(staka/fugumt-en-ja · Hugging Face)を比較。英語文を日本語文に翻訳し、その性能を評価した。評価指標はBLEUで、使用したツールやtokenizerは前回と同じ(sacrebleu –tokenize ja-mecab)である。
  • データセットは外務省WEBサイトのプレスリリース(CC BY互換で利用可)のうち日本語、英語が対応しているページを利用した。評価に使用した対訳ペアは前回と全く同じ。2020年1月~2023年3月で月ごとに5件のプレスリリースを選択し全195件。
  • ベースのプロンプトも前回と同じだがOpenICLを用いて事例部分を変更した。各Retrieverが用いる対訳ペアは評価データとは分けている。
    • RandomRetriever: 対訳事例をランダムに選択、gpt-3.5-turboの最大トークン数に合わせて事例数を変更、結果1-2shot設定となっている。(0-shotにはなっていない)
      直感的には過去の翻訳例をランダムに選んで参考にしている状況に相当する。
    • TopkRetriever①: 対訳事例をTopK「[2101.06804] What Makes Good In-Context Examples for GPT-$3$? (arxiv.org)[6]」に沿って選択。gpt-3.5-turboの最大トークン数に合わせて事例数を変更、結果1-2shot設定となっている。(0-shotにはなっていない)
      直感的には過去の翻訳例から今翻訳しようとしている内容に近いものを選び参考にしている状況に相当する。
    • TopkRetriever②: TopkRetriever①を3-shotに固定して実行。GPT-4で最大トークン数が拡張されているから可能[5]。

結果とまとめ

結果はページ最初の表の通りでTopkRetrieverは高い効果を示した。近い内容の翻訳結果を参照することで単語の対訳や文章スタイルなどを合わせることができBLEUが高くなったものと思われる。

某有償APIを用いた時はBLEU=32.6であった。GPT-3.5 + TopkRetrieverとGPT-4 + TopkRetrieverはこのスコアを超えておりOpenICLの有効性が伺える。有償APIによっては単語登録が可能なものもあり一概には言えないものの、うまくICLを行ったときの翻訳性能は非常に高いと言える。

GPT-3.5の最大トークン数(約4K)に比べGPT-4の最大トークン数は32Kと大幅に拡張されている。本件では最大3-shotの設定[7]で試行しshot数が増えたことによる性能向上も確認できた。

翻訳時に過去の翻訳結果を参照することは一般的に行われており、本検証の設定は無理なものではない(厳密には微妙な部分はあるけど)。LLMを利用した機械翻訳では辞書を参照することが有効という報告もある[8]。プロンプトの工夫や自動作成によってLLMを用いた機械翻訳性能は向上し使い勝手の良いシステムになる事が見込まれる。

脚注

[1] GitHub – Shark-NLP/OpenICL: OpenICL is an open-source framework to facilitate research, development, and prototyping of in-context learning. Zhenyu Wu, Yaoxiang Wang, Jiacheng Ye, Jiangtao Feng, Jingjing Xu, Yu Qiao, and Zhiyong Wu 2023. OpenICL: An Open-Source Framework for In-context Learning. arXiv preprint arXiv:2303.02913.
※sentence_transformerのモデル名を与えることができ日本語も使用可能(例えば↓)
TopkRetriever(data, ice_num=5, sentence_transformers_model_name='paraphrase-multilingual-mpnet-base-v2')
[2] gpt-3.5-turbo-0301
[3] gpt-4-0314
[4] GitHub – nipunsadvilkar/pySBDにより行に分割し、FuguMT(staka/fugumt-en-ja · Hugging Face)で翻訳
[5] GPT-3.5では実行不可の設定
[6] Jiachang Liu, Dinghan Shen, Yizhe Zhang, Bill Dolan, Lawrence Carin, and Weizhu Chen. (2021). What Makes Good In-Context Examples for GPT-$3$?. arXiv preprint arXiv:2101.06804.
[7] 4Kだと1 shotしか無理な場合もあったので、3 shotでも大きな拡張
[8] [2302.07856v1] Dictionary-based Phrase-level Prompting of Large Language Models for Machine Translation (arxiv.org)、Marjan Ghazvininejad, Hila Gonen, Luke Zettlemoyer. Dictionary-based Phrase-level Prompting of Large Language Models for Machine Translation. arXiv preprint arXiv:2302.07856.
[9] 正直、ベンチマークデータの品質がイマイチだったりする…。

その他

OpenICLを試してみたいと思って機械翻訳を題材に検証してみた。結果として商用の機械翻訳システムを超える性能となってびっくり。過去の訳を参照できる条件だと翻訳が容易になるのは当たり前ではあるが、それを自然に自動化できるのはすごい。

LLMの流行やGPT-4の登場によってNLP界隈は激変している。LLMをうまく使う上でICLは一つのキーワードであると思う。なかなか検証が難しい[9]分野であるが今後も定量的評価を行いたい。本件だとICLは「英語→日本語での単語選択への貢献」「日本語のスタイル(常体・敬体など)への貢献」など様々な側面があるはずでその辺りも分けて検証したいところ。

GPT-4を用いた翻訳の検証(vs GPT-3.5 vs FuguMT)

GPT-4の翻訳性能を外務省WEBサイトのテキスト(日本語/英語)を用いて定量的[1]に測ってみた。

検証結果からGPT-4の翻訳性能はGPT-3.5より優れていると言えそう(FuguMTより若干上)。期間別の比較(後述)も行っているが発表されているGPT-4の学習データ期間前後では大きな性能変化はなかった。一方で詳細検討が必要な気がしている[2]。

モデル概要BLEU
GPT-4gpt-4-0314を利用(ゼロショット)30.19
GPT-4 + タイトルgpt-4-0314を利用し対応するページのタイトル(英語・日本語の両方)を与えたもの31.82
GPT-3.5gpt-3.5-turbo-0301を利用(ゼロショット)27.16
GPT-3.5 + タイトルgpt-3.5-turbo-0301を利用し対応するページのタイトル(英語・日本語の両方)を与えたもの29.58
FuguMT英語文書をGitHub – nipunsadvilkar/pySBDにより行に分割し、FuguMTで翻訳31.30
GPT-4、GPT-3.5、FuguMTの性能(概要)、データの詳細は後述

性能評価の方法

性能評価は下記の条件で実施した。

  • ChatGPT API(gpt-3.5-turbo-0301)、GPT-4 API(gpt-4-0314)、FuguMT(staka/fugumt-en-ja · Hugging Face)を比較。英語文を日本語文に翻訳し、その性能を評価した。
    • 評価指標はBLEUで、使用したツールやtokenizerは前回と同じ(sacrebleu –tokenize ja-mecab)である
  • データセットは外務省WEBサイトのプレスリリースのうち日本語、英語が対応しているページを利用した。詳細はデータセットの作成に記載する。
    • 期間は2020年1月~2023年3月、月ごとに5件のプレスリリースを選択[3]、全195件
    • 既存のデータセットはGPT-4、GPT-3.5の学習データとして使われている可能性があり利用を避けた。(加えて性能評価のために適した品質と言えないものも少なくない。)
  • プロンプトは前回のもの(機械翻訳でのChatGPT vs GPT-3.5 vs FuguMT | ぷるーふおぶこんせぷと (staka.jp))を使用、プレスリリースのタイトル(日・英)の対応を参照用として与えたパターンも比較対象とした
    • タイトルを与えることで、参考訳として使用する事及び訳のスタイルを官公庁っぽくすることを狙っている [4]
    • 学習データに外務省のサイトが入っている場合(おそらく入っていると思うが)そのデータを色濃く反映する効果も狙っている
  • 性能評価は全体、2021年9月[2]前後での検証、月別(ある月以降3ヶ月間分のプレスリリースを使用)で評価した。月別の評価と言いつつ3ヶ月移動平均のような処理になっている。(データが少ないことによる苦肉の策)

データセットの作成

データセットは外務省ホームページのPress Releases | Ministry of Foreign Affairs of Japan (mofa.go.jp)を用いて下記手順で作成した。使用したデータは整理後に公開予定[5]。

  1. プレスリリースのうち、日本語と英語の対応が取れるものを取得
  2. 日本語のページと英語のページから本文とタイトルを抽出
  3. 英語のページから日付を抽出
  4. 日本語のページと英語のページを目で比較し、どちらか一方のみにある部分を削除
    • 日本語だけに補足や経緯がある、参考リンクが日本語と英語のページで異なるなど微妙な差異があるため、その部分は対応が必要である。[6]
  5. 2020年1月~2023年3月の記事について長さがちょうどよいものを5件/月を選択した
    • 月内の全記事の中から一定期間ごとになるように5件選択
    • 300文字~1600文字の記事を選択

検証結果

検証結果は下表・下図の通り。 

モデル期間BLEU
GPT-4全期間30.19
GPT-42021/09/01以前29.66
GPT-42021/10/01以降30.82
GPT-4 + タイトル全期間31.82
GPT-4 + タイトル2021/09/01以前31.30
GPT-4 + タイトル2021/10/01以降32.15
GPT-3.5全期間27.16
GPT-3.52021/09/01以前27.04
GPT-3.52021/10/01以降26.87
GPT-3.5 + タイトル全期間29.58
GPT-3.5 + タイトル2021/09/01以前29.34
GPT-3.5 + タイトル2021/10/01以降29.59
FuguMT全期間31.30
FuguMT2021/09/01以前31.65
FuguMT2021/10/01以降30.70
2021年9月を境にした性能変化
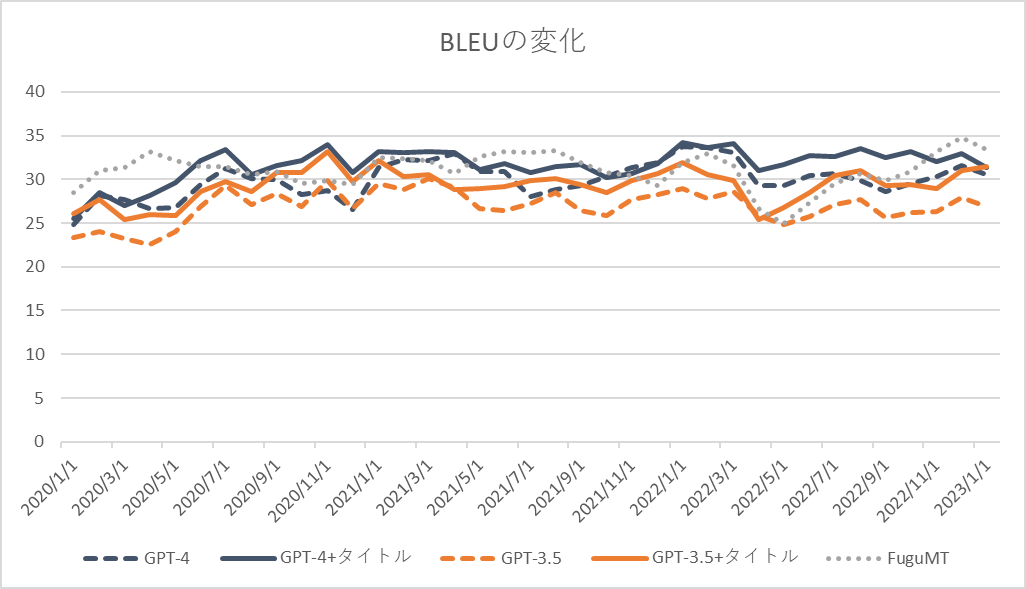
BLEUの時系列変化
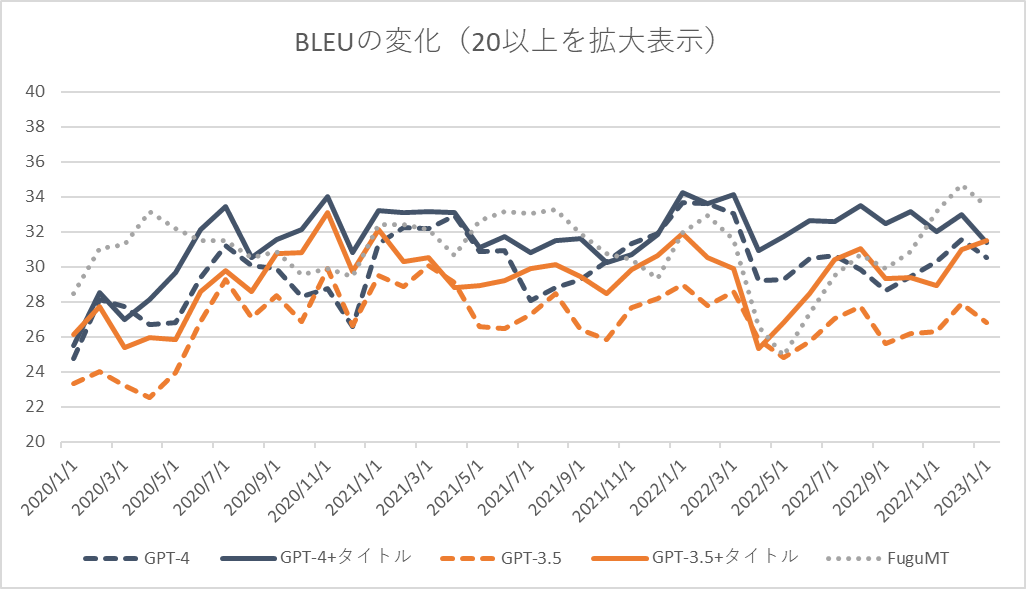
BLEUの時系列変化、BLEU≧20のエリアを拡大表示

まとめ

GPT-4の翻訳性能を外務省WEBサイトの日本語-英語対応を使って検証した。結果としてGPT-4は翻訳性能においてGPT-3.5よりも大幅に優れていた。タイトルを参考訳として使用可能な状況ではFuguMTのような翻訳特化モデルを超える性能を発揮している[7]。

GPT-4の学習データ期間は2021年9月までとのことだが、翻訳性能の変化からはその時期を境にした性能変化は見られなかった。2022年3月~4月ごろに性能の変化がみられるが、FuguMTでも同傾向であり単純に訳が難しいデータになっているだけの可能性がある[8]。

BLEUの経年変化はタイトル行を入れてもFuguMTと概ね同じである。(おそらく学習データに含まれているであろう)ページの日本語訳のコピーを出している場合はFuguMTと動きが異なるはずで、そのような不適切な動作はしていないものと思われる。BLEUの変化のブレが激しくデータを増やす、比較するモデルを変えるなどしての再検証が必要と思われる[9]。

現在のGPT-4 APIでは画像入力ができないが、できるようになったらそれを含めて検証を行いたい。官公庁のサイトでは画像付きの記事も多く、画像+機械翻訳の性能検証は可能だと考えている。

脚注

[1] といってもデータ数は微妙で評価指標はBLEU。。。sacrebleu.corpus_bleu( sys, [ref], tokenize=’ja-mecab’)を使用。
[2] GPT-4 (openai.com)によると「GPT-4 generally lacks knowledge of events that have occurred after the vast majority of its data cuts off (September 2021)」とのこと。データ数も少ないので何とも言えないというところではあるが、特に「Webページの内容を記憶しているだけ」な場合はタイトルをプロンプトに入れることで2021/9を境に大幅な性能変化があるかと期待していたが、そのような結果とはなっていない。
[3] 過負荷のためかOpenAI APIのエラー(’openai.error.RateLimitError’)が多発、検証に用いたデータは少なめである。負荷が落ち着いたら全データを使って検証したいと思っている。
[4] 本当はURLを与えるなどより学習データを濃く反映できそうなパターンも実施したかったが時間の関係上断念した
[5] 2017年1月~現在までで2700件程度のデータが取得可能、本件に使ったもの以外を含め1/3くらいは目検証済みで残りを検証した後に公開する予定である。翻訳の品質が高く、オープンなライセンスで、検証しやすい長さのドキュメント単位、発表日が明確に記載されている貴重なデータである。機械翻訳モデルの時系列での性能劣化を測るために有用だと思っている。
[6] 自分で目検した。結構大変だが何とかなる量ではある。
[7] FuguMTと僅差だと商用の翻訳サービスの性能よりは低めな気がする。ただ、プロンプトで改善できる、訳のスタイル変更が可能、間違いを指摘してくれるなど単純な性能以外の利点は多くあり、それがチャット形式で可能なのは大きな利点。
[8] 実はFuguMTのクローリングデータはちょうどこの時期に追加したのが最後になっている(OCR用翻訳モデルとVR対応論文翻訳 | ぷるーふおぶこんせぷと (staka.jp))。翻訳が難しいデータなのか、たまたまGPTのデータ期間とFuguMTのデータ期間が近いのか、結論を出すのがとても難しい。Google翻訳やDeepLなどの他のエンジンで試すか、FuguMTの過去バージョンで検証する必要がありそうに思っている。
[9] データはあるが、APIの動作が重く検証できる気がしない…参考までに本検証にかかったコストは15USD程度であった。

その他

色々なところで指摘されている事でもあるが、試行しているとGPT-3.5までと比べてGPT-4は日本語性能が大きく向上している。機械翻訳でのBLEUの向上はそれを裏付けている。GPT-3.5までであれば特化型モデル > GPT(LLM+prompt)だったがGPT-4ではそうでもなさそう。おそらく数か月すれば検証結果がそろうはずで興味津々。

本件の検証の目的の一つは2021年9月を境に性能が劣化するか?だったが残念ながら裏付けが取れなかった…全データを使っているわけではなく変化点っぽいものも見えなくはないのでより詳細な検討を行いたいところ。メンバシップ攻撃のようなことをやっている人達もいるかもだが、個人的にはデータの期間をはっきりさせるというよりはleakっぽい理由で性能が高く見えるのかそうでないのか?をはっきりさせたいと思っている。Home | RealTime QAのような取り組みも参考になりそう。

日本語性能の向上やプロンプトの探索などを見るに結構な社会的インパクトを与えるのは間違いなく、どう使っていくか?を考えていく必要がある。初期のインターネットと同じワクワク感がありとても楽しいと思う一方でディスラプトの怖さもある。OpenAIは結構な影響を予測しているFugu-MT 論文翻訳(概要): GPTs are GPTs: An Early Look at the Labor Market Impact Potential of Large Language Models (fugumt.com)が、実際どうなるかはここ数ヶ月で決まるんだろうなーと思う。

社会的なインパクトにも興味があるが、LLMの内部動作の理解、特にマルチリンガルな能力の獲得やIn-Context Learningが可能な理由にも興味がある。マルチモーダルさが入った時の動きも知りたいところ。この手の検証はAPIだととてもやりにくいのでオープンなChatGPT likeモデルに期待大。色々理由はあるのだろうが詳細が非公開というのはやはり辛い。

GPT-4の翻訳性能

GPT-4が発表された(GPT-4 (openai.com))。マルチモーダル化や長い入力への対応など非常に面白い拡張がされている。テキスト部分も性能向上があったとのことで機械翻訳でのChatGPT vs GPT-3.5 vs FuguMT | ぷるーふおぶこんせぷと (staka.jp)の後半の文例で翻訳させてみた。

現在はAPI提供はされておらず画面から「あなたは翻訳者です」と役割を入力し、その後「次の文章を英語から日本語に翻訳してください。」と指示している。入力方法は異なるが前回と条件はほぼ同じのはずである。

APIが提供されれば何らかのデータセットを用いたベンチマークもやってみたいと思っている。ただ下記の結果を見るに、ベンチマークデータの品質が問われるレベルで高い性能だなという印象。

最初に、林大臣は、G20外相会合と日本・オーストラリア・インド・米国外相会合の議長を務めるジャイシャンカル外相のリーダーシップに敬意を表しました。彼は、国際社会が一連の大きな危機に直面している中で、日本は5月のG7広島サミットと9月のG20ニューデリーサミットに向けて取り組み、G20議長国を務めるインドと引き続き緊密に連携していくと述べました。これに対し、ジャイシャンカル外相は、林大臣のインド訪問を歓迎し、G20議長国として、G7議長国である日本と協力したいとの意向を示しました。

※出典:外務省ホームページ (https://www.mofa.go.jp/s_sa/sw/in/page3e_001319.html、機械翻訳を行った結果)
金融庁は、資金移動業者に関する「行政手続きガイドライン」の改正案を公開コメントのために提案しました。この提案は主に、厚生労働大臣が指定する資金移動業者の口座への賃金支払いを認める労働基準法施行規則の改正に関する省令(仮称英語名)[2022年11月28日公布]を受けて、資金移動業者に対する監督措置を定めたガイドラインの改正を提供することを主な目的としています。

※出典:金融庁ウェブサイトhttps://www.fsa.go.jp/en/newsletter/weekly2023/527.html)、機械翻訳を行った結果
デジタル庁は、政府の非効率的な技術を排除するために最善を尽くし、人々の日常生活を支援するシステムのデジタル化に注力しています。データとシステムのセキュリティを保証することで、ユーザー主導のデジタル化を加速させることを目指しています。私たちは、「政府がサービスとして」、「政府がスタートアップとして」のビジョンを基盤に、「人にやさしいデジタル化:誰も取り残さない」というコミットメントを果たします。

※出典:デジタル庁(https://www.digital.go.jp/en/creation-en/)、機械翻訳を行った結果
GPT-4を用いた翻訳結果

GPT-4は全体的に正確かつ流暢に訳せており、前回結果(GPT-3.5、ChatGPT、FuguMT)より優れているように見える。特に3つ目で「デジタル庁」を正しく訳せているのはすごい。「Government as a service」「Government as a startup」「Human-friendly digitalization: No one left behind」の翻訳も良い感じである。

マルチモーダルな入力が可能になったら画像+テキストでの翻訳もぜひ試してみたい。(既存研究はあるものの)マルチモーダルなデータを用いた翻訳&テキスト指示による文のスタイル指定が手軽に実行可能だとするとすごいことだと思う。

その他

この分野はGoogleがPaLM APIを発表(Google Developers Blog: PaLM API & MakerSuite: an approachable way to start prototyping and building generative AI applications (googleblog.com))するなど競争が激化している。LLMの挙動は非常に面白いので色々試していく予定。

現在、GitHub – Shark-NLP/OpenICL: OpenICL is an open-source framework to facilitate research, development, and prototyping of in-context learning.のようなIn-Context Learningもテスト中でその結果も早めに記事にしたいなーと思っている。in-context Learningの挙動も謎が多く(Larger language models do in-context learning differently – arXiv最新論文の紹介 (devneko.jp))非常に興味深い。

GitHub – dair-ai/Prompt-Engineering-Guide: Guides, papers, lecture, and resources for prompt engineeringのようなPrompt作成のテクニックが日本語でも同じなのか?など、LLM周りが急速に発展する中での日本語の立ち位置にも興味津々で実験時間が足りないというのが正直なところ。

機械翻訳でのChatGPT vs GPT-3.5 vs FuguMT

ChatGPTがAPI提供されるようになったこともあり、機械翻訳性能がどの程度変わっているか試してみた。比較条件は下記の通り。

評価結果

結果は下表の通りであり、FuguMT > GPT-3.5 > ChatGPTの結果だった。

パターンBLEU補足
ChatGPT(Excellent)22.850.4/29.0/16.9/10.9 (BP = 1.000 ratio = 1.228 hyp_len = 6920 ref_len = 5633)
ChatGPT(Good)23.251.0/29.3/17.4/11.2 (BP = 1.000 ratio = 1.196 hyp_len = 6735 ref_len = 5633)
GPT-3.524.956.0/31.7/18.5/11.7 (BP = 1.000 ratio = 1.068 hyp_len = 6014 ref_len = 5633)
FuguMT32.763.5/40.2/26.0/18.6 (BP = 0.982 ratio = 0.982 hyp_len = 5531 ref_len = 5633)
Tatoebaを用いたBLEUの比較(ChatGPT vs GPT-3 vs FuguMT)

ChatGPTの出力には()書きでローマ字の読みが補足されている場合(「Hello」の翻訳として「こんにちは(Konnichiwa)」となっているような場合)があり、それを修正すると下表の結果となった。

パターンBLEU補足
ChatGPT(Excellent)26.557.6/33.5/19.8/13.0 (BP = 1.000 ratio = 1.077 hyp_len = 6064 ref_len = 5633)
ChatGPT(Good)26.056.3/32.6/19.5/12.8 (BP = 1.000 ratio = 1.084 hyp_len = 6104 ref_len = 5633)
Tatoebaを用いたBLEU、ChatGPTの出力を修正した場合

若干修正しても単文(かつ短め)翻訳においてはFuguMTはChatGPT・GPT-3よりも性能が高いという結果になった。ただし、Tatoebaの結果で正しい性能を測ることはそもそも困難であること、BLEUが良い指標とは言い難いこと、ChatGPTの出力は機械的な評価以上に人間に好まれること[2][3]に注意が必要である。実際に目検証を行った限りではChatGPTとFuguMTの性能はほぼ同じレベルに見えた(GPT-3.5はイマイチな訳が含まれていた)。そして、そもそもゼロショットで機械翻訳特化のモデルに相当しているというのも凄いことである。

追加検証

追加検証として外務省、金融庁、デジタル庁のWEBサイトにある英語文を用いて比較を行った。

外務省のデータ

まずはJapan-India Foreign Ministers’ Meeting | Ministry of Foreign Affairs of Japan (mofa.go.jp)から下記文章を抜き出し検証した。

At the outset, Minister Hayashi expressed his respect for Foreign Minister Jaishankar’s leadership in chairing the G20 Foreign Ministers’ Meeting and the Japan-Australia-India-US Foreign Ministers’ Meeting. He stated that as the international community faces a series of major crises, Japan is looking ahead to the G7 Hiroshima Summit in May and the G20 New Delhi Summit in September, and expressed that Japan will continue to work closely with India, which holds the G20 Presidency. In response, Foreign Minister Jaishankar welcomed Minister Hayashi’s visit to India and stated that as G20 Presidency, India would like to cooperate with Japan, which holds the G7 Presidency.

出典:外務省ホームページ (https://www.mofa.go.jp/s_sa/sw/in/page3e_001319.html、機械翻訳を行った結果を下表に表示)

この程度の長さであれば一文が入力されることを想定したFuguMTでも対応可能だが、テキスト中の行を分割後に翻訳したバージョンも記載している。なお、「外務省」「金融庁」「デジタル庁」など省庁のテキストの多くはクリエイティブ・コモンズ (Creative Commons) — 表示 4.0 国際 — CC BY 4.0と互換性のある利用規約で使うことができる。

パターン日本語訳
ChatGPT(Excellent)冒頭、林大臣は、ジャイシャンカル外相がG20外相会議と日豪印米外相会議の議長を務めたことへの尊敬を表明しました。彼は、国際社会が一連の大危機に直面する中、日本は5月のG7広島サミットと9月のG20ニューデリーサミットに注目し、G20大統領国のインドと引き続き緊密に連携していくと述べました。これに対し、ジャイシャンカル外相は、林大臣のインド訪問を歓迎し、G20大統領国であるインドは、G7大統領国である日本と協力したいと述べました。
ChatGPT(Good)最初に、林大臣は、ジャイシャンカル外務大臣がG20外相会議や日豪印米外相会議で議長を務めたことについて、彼の指導力に対する敬意を表明しました。彼は、国際社会が一連の重大な危機に直面している中、日本は5月のG7広島サミットと9月のG20ニューデリーサミットを見据えており、G20の議長国であるインドと緊密に連携していくと表明しました。これに対し、ジャイシャンカル外務大臣は、林大臣のインド訪問を歓迎し、G20議長国であるインドはG7議長国である日本と協力したいと述べました。
GPT-3.5最初に、林大臣はG20外務大臣会議と日豪印米外務大臣会議を主席としたジャイシャンカール外務大臣の領導力を尊敬した。彼は、国際社会が一連の重大な危機に直面していると述べ、5月にはG7広島サミット、9月にはG20ニューデリーサミットがあると述べ、G20議長国であるインドと緊密に協力していくと表明した。それに対し、ジャイシャンカール外務大臣は林大臣のインド訪問を歓迎し、G20議長国として日本、G7議長国として日本と協力したいと述べた。
FuguMT冒頭,林大臣から,ジャイシャンカル外相のG20外相会合及び日米豪印外相会談の議長に対する敬意を表明しました。国際社会が一連の大きな危機に直面する中で,5月のG7広島サミット,9月のG20ニューデリーサミットを先取りし,引き続きG20議長国であるインドと緊密に連携していく旨述べました。これに対し,ジャイシャンカル外務大臣から,ハヤシ外相の訪印を歓迎し,G20議長国として,G7議長国である日本と協力していきたい旨述べました。
FuguMT(行分割)冒頭,林大臣から,G20外相会合及び日米豪印外相会談の議長として,ジャイシャンカル外務大臣のリーダーシップを尊重する旨述べました。 5月のG7広島サミット、9月のG20ニューデリーサミットに向けて、国際社会が一連の大きな危機に直面する中、日本は引き続きG20議長国であるインドと緊密に連携していく旨述べました。 これに対し,ジャイシャンカル外務大臣から,林大臣のインド訪問を歓迎し,G20議長国として,G7議長国である日本と協力していきたい旨述べました。
外務省のページに対する各パターンの翻訳結果

外務省の日本語記載は下記の通りである。

冒頭、林大臣から、今般のG20外相会合及び日米豪印外相会合の議長としてのジャイシャンカル外相のリーダーシップに敬意を表明するとともに、国際社会が大きな危機に立て続けに直面する中、日本は、5月のG7広島サミット及び9月のG20ニューデリー・サミットを見据え、G20議長国であるインドと、引き続きしっかり連携していきたい旨述べました。これに対し、ジャイシャンカル外相より、林大臣の訪印を歓迎した上で、G20議長国としてG7議長国である日本と協力していきたい旨述べました。

出典:外務省ホームページ (https://www.mofa.go.jp/mofaj/s_sa/sw/in/page6_000819.html)

全般的に甲乙をつけるのが難しいが、GPT-3.5は若干微妙な訳になっているように見える。FuguMTも誤訳のように思えなくもない(解釈が悩ましい文章になっている)。このように小さな単位で測っても…と思いつつBLEUを計算すると FuguMT(行分割) > FuguMT > ChatGPT(Excellent) > ChatGPT(Good) > GPT-3.5だった。

金融庁のデータ

金融庁の下記テキストを翻訳した結果は下表の通り。

The FSA proposed the draft amendments to the “Guidelines for Administrative Processes” regarding funds transfer service providers for public consultation.The proposal is mainly aimed at providing amendments to the said Guidelines by setting forth supervisory measures to be taken for funds transfer service providers, in response to the “Ministerial Order to Amend the Regulation for Enforcement of the Labor Standards Act to Allow Wage Payment to the Accounts of Funds Transfer Service Providers Designated by the Minister of Health, Labor and Welfare” (provisional English title) [promulgated on November 28, 2022].

出典:金融庁ウェブサイトhttps://www.fsa.go.jp/en/newsletter/weekly2023/527.html)、機械翻訳を行った結果を下表に表示
パターン日本語訳
ChatGPT(Excellent)FSAは、公共の意見募集のために、資金移転サービスプロバイダーに関する「行政手続指針」の草案改正案を提案しました。この提案は、主に「労働基準法施行規則の改正により、厚生労働大臣が指定した資金移転サービスプロバイダーの口座への賃金支払いを認める」という大命令に対応して、資金移転サービスプロバイダーに対する監督措置を定めることにより、当該指針の改正案を提供することを目的としています。
ChatGPT(Good)FSAは、公開の意見募集のために、資金移転サービスプロバイダに関する「行政手続に関する指針」の草案を提案しました。この提案は、主に、厚生労働大臣が指定した資金移転サービスプロバイダの口座への賃金支払いを許可するための「労働基準法施行規則の改正に関する省令案」(暫定英語タイトル)(2022年11月28日公布)に対応して、資金移転サービスプロバイダに対して取られるべき監督措置を明示することで、該指針の改正案を提供することを目的としています。
GPT-3.5「厚生労働大臣令による労働基準法施行規則の改正(仮英語表記)(2022年11月28日公布)に対応して、資金振込サービス提供者に対する監督措置を定めることを目的として、「行政処理のガイドライン」に関する案を公開諮問することを金融庁が提案しました。
FuguMTFSAは、公共相談のための資金移転サービス提供者に関する「行政プロセスガイドライン」の改正案を提案しました。この提案は、主に、「厚生労働大臣が指定する資金移転サービス事業者の口座への賃金支払いを許可する労働基準法施行規則の改正に関する閣僚令」(仮称)に対応して、資金移転サービス事業者に対して取るべき監督措置を設定することにより、当該ガイドラインの改正案を提供することを目的としています(仮称) [2022年11月28日に公布]。
FuguMT(行分割)FSAは、公的協議のための資金移転サービスプロバイダーに関する「行政プロセスガイドライン」の修正案を提案した。 この提案は、主に「厚生労働大臣が指定する資金移転サービス事業者の口座への賃金支払いを許可する労働基準法施行規則の改正に関する閣僚令」(仮称)(2022年11月28日公布)に対応し、資金移転サービス事業者に対して取るべき監督措置を定めることにより、当該ガイドラインの改正を行うことを目的とするものです。
金融庁のページに対する各パターンの翻訳結果

GPT-3.5以外は甲乙つけがたし、という印象。GPT-3.5は一部を飛ばしてしまっている。もっとも大意があっていればOKという感想はなくはない。

デジタル庁のデータ

最後にデジタル庁のテキストを翻訳した結果は下表の通り。

The Digital Agency makes best effort to eliminate inefficient technology of the government and focuses on the digitalization of improving systems to support daily lives of people. By guaranteeing the security of data and systems, we aim to accelerate digitalization in a user-driven manner. We commit to “Human-friendly digitalization: No one left behind”, underpinned by the vision of “Government as a service” and “Government as a startup.”

出典:デジタル庁(https://www.digital.go.jp/en/creation-en/)、機械翻訳を行った結果を下表に表示
パターン日本語訳
ChatGPT(Excellent)デジタル・エージェンシーは、政府の非効率な技術を排除し、人々の日常生活をサポートするシステムの改善のデジタル化に注力しています。データとシステムのセキュリティを保証することで、ユーザー中心のデジタル化を加速することを目指しています。「誰も後れを取らない」人間にやさしいデジタル化を実現することを約束し、「サービスとしての政府」と「スタートアップとしての政府」というビジョンを土台にしています。
ChatGPT(Good)デジタルエージェンシーは、政府の非効率的な技術を取り除き、人々の日常生活を支援するシステムの改善に重点を置くことでデジタル化に取り組んでいます。また、データやシステムのセキュリティーを保証することで、ユーザー主導のデジタル化を加速することを目指しています。私たちは、「誰一人取り残さない人間中心のデジタル化」というビジョンのもと、「政府サービス」と「政府スタートアップ」という考え方を基盤として、取り組んでいきます。
GPT-3.5デジタルエージェンシーは、政府の不効率な技術を排除し、人々の日常生活を支援するシステムのデジタル化に焦点を当てるための最善の努力をしています。データとシステムのセキュリティを保証することにより、ユーザー主導のデジタル化を加速します。私たちは「人間中心のデジタル化:誰も残さない」を掲げ、「政府をサービスとして」および「政府をスタートアップとして」というビジョンに基づいています。
FuguMTデジタルエージェンシーは、政府の非効率な技術を排除するために最善を尽くし、人々の日常生活を支えるシステム改善のデジタル化に重点を置いています。データとシステムのセキュリティを保証することで、ユーザー主導のデジタル化を加速することを目指しています。私たちは、「Government as a service」と「Government as a startup」のビジョンに裏付けられた「Human-friendly digitalization: No one left back」にコミットします。
FuguMT(行分割)デジタルエージェンシーは、政府の非効率な技術を排除するために最善を尽くし、人々の日常生活を支援するためのシステムの改善のデジタル化に焦点を当てています。 データとシステムのセキュリティを保証することで、ユーザ主導のデジタル化を加速することを目指しています。 私たちは、「サービスとしての政府」と「スタートアップとしての政府」のビジョンに裏付けられた「人間に優しいデジタル化:誰も残っていない」ことを約束します。
デジタル庁のページに対する各パターンの翻訳結果

こちらは全般的に近い翻訳で評価が難しい。GPT-3.5の「不効率」という表記は気になるが、それ以外はまぁ機械翻訳だしこんなもんか、という結果に思える。

まとめ

ChatGPT vs GPT-3.5 vs FuguMTということで翻訳性能を比較してみた。機械的な評価ではFuguMTが上回るが、個別にみていくと甲乙つけがたい結果であることが確認できた(ただ、おそらくChatGPTはGPT-3.5よりも和訳性能が高い)。

LLMを用いた翻訳はPromptの入れ方に依存して性能が変わることがある。実際にChatGPTではSystem Roleに与えたテキストによって訳文が変化している(スコア的にはそこまで変わらずExcellent > Goodということはなさそう)。他論文でも指摘されているが、Promptの工夫や今後のSoft Prompt[4][5]のような技術を適用することで性能はさらに上がっていくものと思われる。

ゼロショットで良い翻訳性能を出したLLMは驚異的とも言え、また、その性質上文単位ではなくドキュメント単位で情報を捉える事も可能、翻訳文のスタイルもコントロール可能と利点が多い。ChatGPTの会話の中で出力させていくUXも素晴らしく、使っていて楽しい。[2]にも書かかれていたように(裏側では)翻訳特化モデルと大規模言語モデル(LLM)+PromptのHybridで使っていくことになるのかなと思う。

FuguMTとしては「ChatGPTに勝ったぜ」と宣伝するのではなく、文書単位(文単位を超える)機械翻訳モデルへ性能強化するとか、英語OnlyなLLMを使うときに役立つ機能(<t1></t1>で挟まれた部分は訳文でも同じタグで挟まれているようタグ構造を保存して翻訳するなど)を入れるとかそういう方向で強化を行っていきたい。

その他

流行りのChatGPT API(gpt-3.5-turbo)、GPT-3.5 API(text-davinci-003)をFuguMTと比較してみたが、ぶっちぎりで負けているようなことが無くて安心した。OpenAIが使っているデータに日本語が少ないという理由だと悲しいが…

LLM (Large Language Model / 大規模言語モデル)の良さはzero / few shotで動くモデルが作れることにあり、No Data, No Codeで特化型モデルであるFuguMTと遜色ない性能を出しているのは正直凄い。[6]によるとGLUEにおけるChatGPTの性能は(得意不得意の差が大きいが平均的には)BERT-baseでfine tuningした結果と同等、BERT-largeやRoBERTaには及ばないとのこと。FuguMTはTransformer世代で約60Mパラメータ(BERT-baseは約110Mパラメータ)であることを考えるとだいたい想定通りの結果ともいえる。

上記結果を「あらゆるユーザが自分の欲しい”AI”をNo Code, No Dataで生み出せ、その性能はBERT-baseを用いてそこそこのデータでfine tuningした結果と同等」と捉えると世の中にかなりのインパクトがあってもおかしくない。Twitterを見ていると様々なタスクにChatGPTを使うユーザがいて、そのタスクには今まで想定されていなかったものが含まれている。データがいらないという点も重要でまさに「AIの民主化」と言えそう。今まで研究者やエンジニアが想像もしなかった用途で有用な”AI”が出てくる可能性は高い。とっても楽しみ。

NLP業界に与える影響としては、現時点では特化型モデルの方が性能が高い(上記、有用な”AI”のアイデアについてLLMの性能を超えることは可能)とかFATE(Fairness, Accountability, Transparency, Ethics)やRobustness[7]といったモデル性能以外に重要な要素も多数ある[8]ので、分野としての仕事は減らないかむしろ増える気がする。

ChatGPTが嘘を言う、いわゆるHallucinationの問題は機械翻訳やAbstractiveな要約といったテキスト生成でも生じる(生じてきた)問題で応用によっては解決可能。もちろん用途によっては対策が難しいかもしれないし、あまり考えずにChatGPTに頼る場合は問題になるが、現実的には何とかできる感がある。

少し未来のことを考えると今後もLLMの進化は止まらなさそう。上で挙げたfew-shot以上の事例をPromptに埋め込むSoft PromptやCoT(Chain of Thought)[9][10]、PAL(Program-Aided Language models)[11]のようにPromptを工夫する方向性の他、LLM自体の高度化としてマルチモーダル化や外部知識の利用、APIの活用など様々な方向性[12]が研究されている。
個人的にはマルチモーダル化に期待したいところ。自然言語+画像の大規模モデル構築の試みは非常に多く行われていてかつ成果も上がっている。視覚+言語理解を得たChatGPTが登場するのはそう遠くないと思う。その後、テーブルデータの理解(またはAutoMLとの統合)や計画・手順の理解がなされると”AIエンジニアGPT”のようなレベルに達する。それぞれについて研究成果が複数あるので意外と早く実現してしまうかもしれない。

この方向でAGIに達するかは不明だが、社会にインパクトを与えうる動きとして注目していきたい。

注釈・参考文献

[1] 単純に学習データに入れないだけではなく、英文側から数字記号を削除し小文字に直したデータをキーとして一致するものが学習データに含まれていないことを確認している。(複文の一部に含まれている場合は検出できないが…)
[2] [2302.09210v1] How Good Are GPT Models at Machine Translation? A Comprehensive Evaluation (arxiv.org)ではもっと詳細に検証されている。
[3] 要約だと[2302.08081] Exploring the Limits of ChatGPT for Query or Aspect-based Text Summarization (arxiv.org)には「we can tell the ChatGPT-generated summaries are surprisingly good and even better than the given references」との記載がある。
[4] The Power of Scale for Parameter-Efficient Prompt Tuning – ACL Anthology
[5] [2302.06541v1] Towards Agile Text Classifiers for Everyone (arxiv.org)
[6] [2302.10198v1] Can ChatGPT Understand Too? A Comparative Study on ChatGPT and Fine-tuned BERT (arxiv.org)
[7] RobustnessはLLMの方が良いかも?と言われていたりもする。[2302.12095v1] On the Robustness of ChatGPT: An Adversarial and Out-of-distribution Perspective (arxiv.org)
[8] [2110.01167] Trustworthy AI: From Principles to Practices (arxiv.org)
[9] [2201.11903] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (arxiv.org).
[10] その後も非常に多くの報告が出ている Chain of Thought – arXiv最新論文の紹介 (devneko.jp)
[11] [2211.10435v1] PAL: Program-aided Language Models (arxiv.org)
[12] [2302.07842] Augmented Language Models: a Survey (arxiv.org)